
LLMO・AIO対策の最初の点検は、「JavaScriptを実行しないで受け取るHTMLに、本文が入っているか」を数えることだ。ChatGPT・Claude・Perplexityのクローラーは、JavaScriptを実行するかを公式に明らかにしていない。HTMLに本文があれば、実行してもしなくても本文は届く。LIFRELLが運営する3つのサイト(コーポレートサイト・LIF Tech・婚活メディア)の8ページを、AIのクローラーのUser-Agentで取得して数えたところ、本文はすべてHTMLに入っていた。一方、別の企業のオウンドメディアでは、全記事で本文が0文字だった。本記事では、この差を自社サイトで5分で確かめる手順と、robots.txtの確かめ方をまとめる。
この記事の前提:自社サイトの計測は2026年11月7日 10:05〜10:08(日本時間)、macOS 15.4.1・curl 8.7.1・Google Chrome 156で実施。User-Agent(UA)を名乗って取得しただけで、各社の本物のクローラーが同じHTMLを受け取ったことまでは確かめていない(詳しくは「正直に書く」の節)。別企業の事例は2026年11月の計測で、社名・サービス名は伏せる。
この記事でわかること
- なぜ「AIに本文が見えているか」がLLMO・AIO・GEO対策の入口になるのか(公式に言えることと、言えないこと)
- AIのクローラーの種類と役割、robots.txtでの効き方の違い
- 自社3サイト8ページの実測結果と、本文が0文字だった別企業の事例
- ブラウザ・curl・robots.txtで確かめる手順と、そのまま使えるチェックリスト
 執筆:佐藤 祐介(株式会社LIFRELL 代表取締役/業界歴15年・マーケティング支援 累計500社以上)
1. なぜ「AIに本文が見えているか」から始めるのか
LLMO対策・AIO対策・GEO対策と呼び方は違っても、狙いは同じだ。ChatGPTやPerplexity、GoogleのAI Overviewsが答えを作るときに、自社のページを読んで、引用元として選んでもらうこと。その前提として、AIのクローラーがページの本文を受け取れている必要がある。読めていないページは、選ばれる候補にも入らないと考えられる。
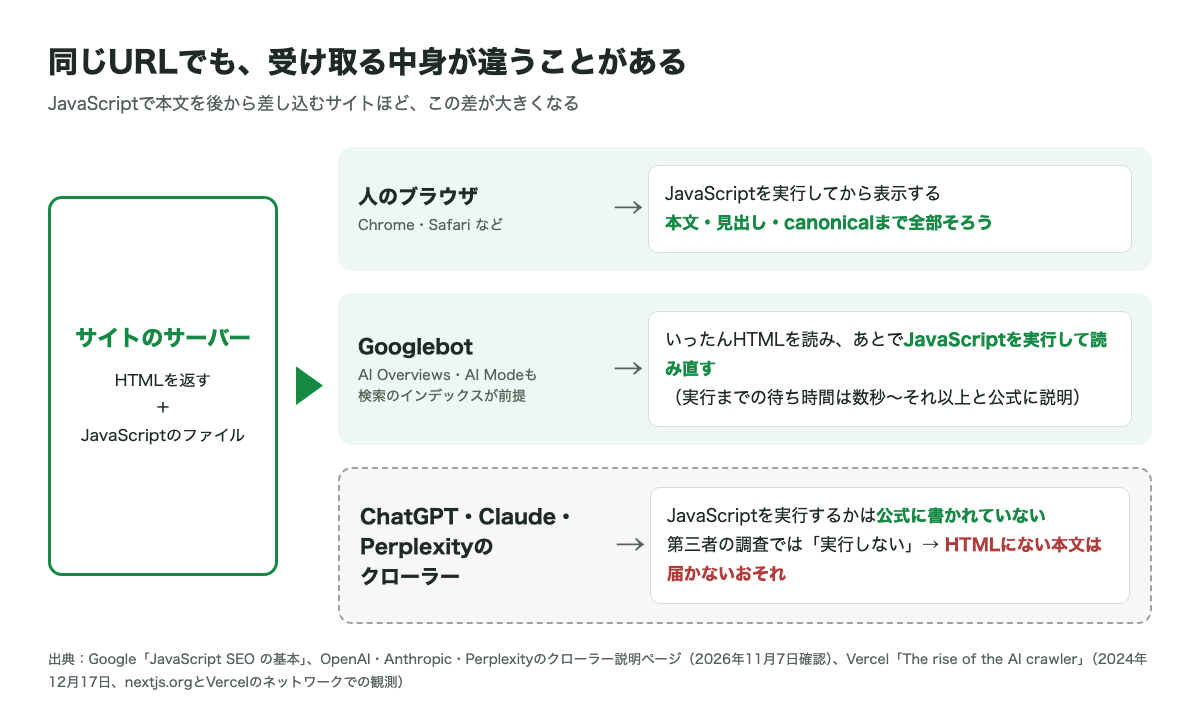
ここで問題になるのがJavaScriptだ。最近のサイトには、最初に返すHTMLはほぼ空で、ブラウザがJavaScriptを実行してから本文を差し込む作りのものがある。人がブラウザで見るぶんには違いがわからない。違いが出るのは、JavaScriptを実行しない読み手が来たときだ。
公式に言えること
- Googlebotは、JavaScriptを実行して読み直す。Googleは、JavaScriptを使うページを「クロール」「レンダリング」「インデックス登録」の3段階で処理し、レンダリング待ちは数秒のこともあればそれより長いこともあると説明している。同じページで、サーバー側でのレンダリングやプリレンダリングを勧め、すべてのボットがJavaScriptを実行できるわけではないとも書いている(Google「JavaScript SEO の基本」)。
- GoogleのAI Overviews・AI Modeに出る条件は、通常の検索と同じ。インデックスに登録され、スニペット付きで表示できる状態であることが条件で、追加の技術要件はないと説明している。基本の一つに「重要な内容をテキストで用意する」ことを挙げている(Google「AI 機能とウェブサイト」)。
- OpenAI・Anthropic・Perplexityのクローラー説明ページには、JavaScriptを実行するかどうかの記載がない(2026年11月7日に確認)。
公式ではないが、判断材料になること
Vercelは2024年12月17日の記事で、自社が運営するnextjs.orgと自社ネットワークの観測から、OpenAI・Anthropic・Meta・ByteDance・Perplexityの主要なAIクローラーはJavaScriptを実行していなかったと報告している(Vercel「The rise of the AI crawler」)。第三者の観測で、時期も約2年前だ。今も同じかはわからない。
だからこそ、確かめる基準は一つに絞れる。「JavaScriptを実行しないHTMLに、本文が入っているか」。入っていれば、AIのクローラーがJavaScriptを実行してもしなくても本文は届く。入っていなければ、届くかどうかは各社の仕組みしだいになる。
2. AIのクローラーは1種類ではない
「AIのクローラー」とひとまとめにされがちだが、各社とも役割の違う複数のクローラーを持っている。robots.txtで止めたときの影響も、役割ごとに違う。次の表は、各社の公式ページ(2026年11月7日確認)の説明をまとめたものだ。
| 会社 | 名前 | 役割(公式の説明) | robots.txtで止めると |
|---|---|---|---|
| OpenAI | OAI-SearchBot | ChatGPTの検索機能にサイトを表示する | ChatGPTの検索の回答に表示されなくなる。反映には約24時間 |
| OpenAI | GPTBot | 生成AIの基盤モデルの学習に使う可能性のある内容を集める | 学習に使わないでほしいという意思表示になる |
| OpenAI | ChatGPT-User | ユーザーの質問やGPTsの操作に応じてページを訪れる | ユーザー起点のためrobots.txtが適用されない場合がある |
| Anthropic | ClaudeBot | モデルの学習用に公開ウェブの内容を集める | 以後の内容を学習データから外すという意思表示になる |
| Anthropic | Claude-SearchBot | 検索結果の質を上げるためにクロールする | 検索のための索引に入らず、表示が減る可能性がある |
| Anthropic | Claude-User | ユーザーの質問に応じてページを取得する | 質問への回答のための取得ができなくなる |
| Perplexity | PerplexityBot | Perplexityの検索結果にサイトを表示・リンクする(基盤モデルの学習には使わない) | 検索結果に出すには許可を推奨 |
| Perplexity | Perplexity-User | ユーザーの質問に答えるためにページを訪れる | ユーザー起点のため、一般にrobots.txtを無視する |
| Googlebot | Google検索のクロール。AI Overviews・AI Modeも検索のインデックスが前提 | 検索にもAI Overviewsにも出なくなる | |
| Google-Extended | Geminiの学習とグラウンディングへの利用を管理する。独自のUAはなく、robots.txt用の名前だけ | Google検索への掲載や順位には影響しないと説明 |
出典:OpenAI「Overview of OpenAI Crawlers」、Anthropic ヘルプセンター、Perplexity「Perplexity Crawlers」、Google「Google の一般的なクローラ」
ポイントは2つある。一つは、「学習用」と「検索・回答用」は別のクローラーで、別々に止められること。学習を断っても、検索・回答への表示まで止まるわけではない。もう一つは、Google-Extendedはアクセスしてこないことだ。robots.txtに書く名前として存在するだけなので、UAを名乗って取得するテストには使えない。確かめるのはrobots.txtの記述だけになる。
3. 実測:自社3サイト8ページをAIのクローラーとして取得した
やったこと
ふつうのChromeのUAと、各社の公式ページに載っているUA(GPTBot、OAI-SearchBot、ChatGPT-User、PerplexityBot、Perplexity-User、Googlebot)の計8種類で、同じ8ページをcurlで取得した。ClaudeBotは、Anthropicの公式ページにUAの全文が載っていないため、「ClaudeBot/1.0」を含む文字列で代用した。curlはJavaScriptを実行しないので、受け取ったHTMLがそのまま「JavaScriptを実行しない読み手に届く中身」になる。
受け取ったHTMLの<body>から、script・style・noscript・template・svg・iframeを除き、空白を除いた文字数を数えた。あわせて、h1・h2・pの数、canonical、robotsメタタグを記録した。比較のために、ヘッドレスのChromeでJavaScriptを実行した後のページも同じ方法で数えた。
結果
| ページ | 本文の文字数(GPTBot) | h1 / h2 / p | JavaScript実行後に対する割合 |
|---|---|---|---|
| lifrell.co.jp トップ | 7,026 | 1 / 9 / 94 | 100.0% |
| lifrell.co.jp アドアフィの解説ページ | 14,567 | 1 / 14 / 161 | 96.5% |
| lifrell.co.jp 記事LP制作の事例ページ | 3,719 | 1 / 8 / 64 | 93.6% |
| LIF Tech トップ | 15,964 | 2 / 10 / 22 | 97.2% |
| LIF Tech 記事(Search Consoleの検証) | 7,413 | 1 / 10 / 43 | 89.9% |
| LIF Tech 記事(GEO・LLMO対策ガイド) | 13,800 | 3 / 18 / 66 | 85.4% |
| 婚活パラダイス 記事(名古屋の相談所) | 21,448 | 1 / 15 / 77 | 91.9% |
| 婚活パラダイス 記事(後悔パターン) | 14,464 | 1 / 15 / 108 | 90.6% |
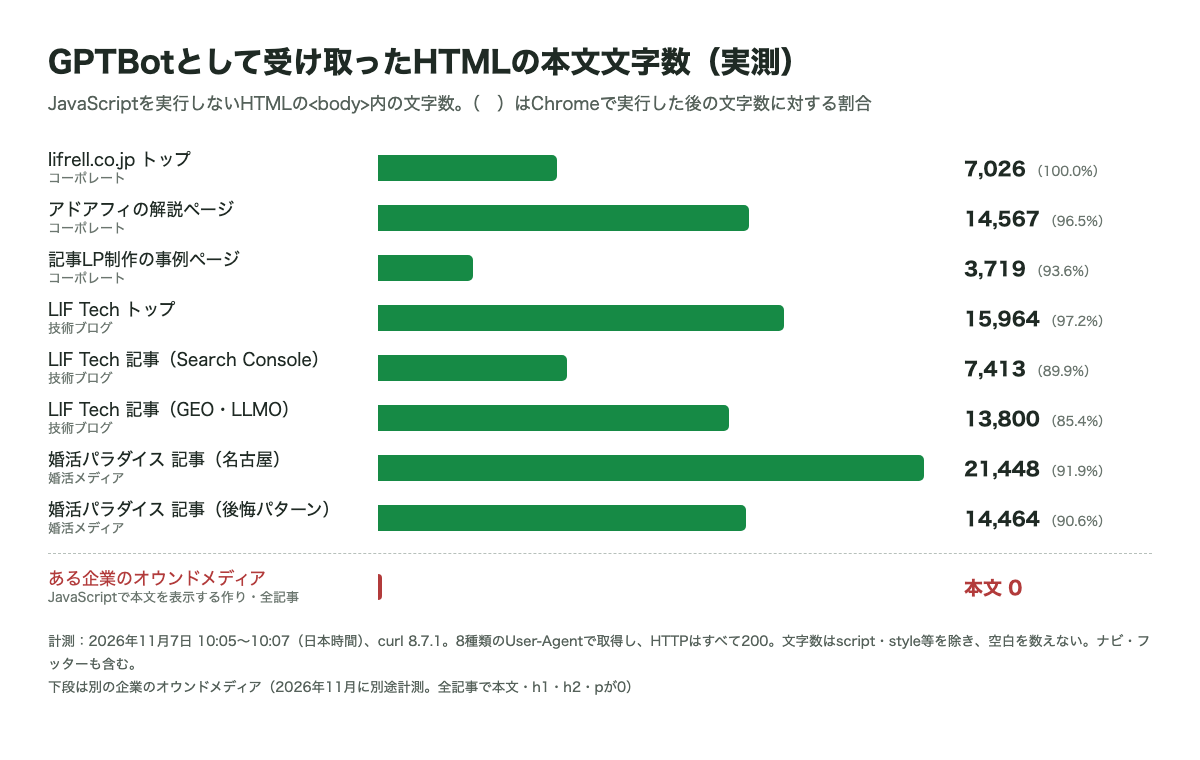
わかったことは4つ。
- 8ページとも、本文はJavaScriptなしのHTMLに入っていた。JavaScript実行後の文字数に対して85.4〜100%。
- 8種類のUAで、受け取ったHTMLはほぼ同じだった。すべてHTTP 200。本文の文字数の差は、名古屋の記事で最大48文字(ページ内で毎回入れ替わる部分の差)で、ほかの7ページは0文字。h1・h2・pの数はすべてのUAで一致した。
- JavaScriptを実行した後にだけ増えた文字は、目次・言語切り替えのメニュー・「もっと見る」などのボタンだった。本文の段落や見出しではない。
- 点検していて、直すべき点も見つかった。LIF TechのGEO・LLMO対策ガイドはh1が3つ、LIF Techのトップはh1が2つあった。本文が届くかどうかとは別の話だが、ページの主題を示す見出しが1つに定まっていない状態だ。
3サイトとも、WordPressでサーバー側がHTMLを組み立てて返す作りだ。この作りなら、記事本文がHTMLに入っているのはふつうのことで、今回の結果も予想どおりだった。差が出るのは、次の事例のような作りのサイトだ。
4. 実例:本文が「0文字」だったオウンドメディア
2026年11月に、ある企業のオウンドメディア(JavaScriptで本文を表示する作りのサイト)を同じ方法で調べた。サイトマップに載っている全記事を、GPTBotのUAで取得した結果は次のとおり。
| 見たもの | 結果 |
|---|---|
| 本文・h1・h2・p | 全記事で0。HTMLに含まれる見える文字は、どの記事もメニュー程度だけ |
| 同じテーマの競合サイト | HTMLに本文が入っていた |
| canonical | JavaScriptで後から付く作りで、JavaScriptを実行しないHTMLにはなかった |
| URL末尾の「/」 | 「/」あり・なしの両方がページとして表示され、両方のURLに検索順位が付いていた |
ブラウザで開けば、どの記事もきちんと読める。人の目では問題が見えない。JavaScriptを実行しない読み手に届くのは、ほぼ空の枠だけだ。
この状態で何が起きるかは、確かな部分と仮説の部分に分けて考える必要がある。
- 確かなこと:JavaScriptを実行しない読み手は、本文を受け取れない。Googleは、JavaScriptでcanonicalを付けるなら、元のHTMLと同じ値にするよう求めている(同上)。元のHTMLにcanonicalがない作りでは、JavaScriptを実行しない読み手は正規のURLを知る手がかりがない。
- 有力な仮説:ChatGPT・Claude・Perplexityの検索や回答で、この記事群が引用元として選ばれにくくなっていると考えられる。ただし、各社とも引用元の選び方を公開しておらず、このサイトのAIからの流入を比べた計測もしていない。
- Google検索については別:GooglebotはJavaScriptを実行するので、本文はレンダリング後に読まれうる。「/」あり・なしの両方に順位が付いていたことからも、Googleがページの中身を読んでいることはうかがえる。そのうえで、同じ記事が2つのURLに分かれている点は、別の問題として残る。
5. 手順:自社サイトで確かめる
STEP 1:ブラウザで「ページのソース」を見る(1分)
確かめたい記事をChromeで開き、アドレスバーのURLの前にview-source:を付けて開く(右クリックの「ページのソースを表示」でも同じ)。表示されるのは、JavaScriptを実行する前のHTMLだ。記事の本文から一文をコピーして、Command+F(WindowsはCtrl+F)で探す。見つかれば、その一文はHTMLに入っている。
注意したいのは、デベロッパーツールの「要素」タブで探さないことだ。要素タブはJavaScriptを実行した後の状態を表示するので、本文が見えて当然になる。
STEP 2:JavaScriptを止めて表示する(1分)
デベロッパーツールを開き、Command+Shift+P(Windows・LinuxはCtrl+Shift+P)でコマンドメニューを出す。「javascript」と打って「Disable JavaScript」を選び、ページを再読み込みする(Chrome DevTools「JavaScript を無効にする」)。本文が消える、真っ白になる、読み込み中の表示のまま止まる場合は、本文をJavaScriptで差し込んでいる。この設定はそのタブでデベロッパーツールを開いているあいだだけ効き、閉じれば元に戻る。
STEP 3:AIのクローラーのUAで取得して数える(3分)
ターミナル(MacならアプリケーションのユーティリティにあるTerminal)で次を実行する。URLと、探す一文は自社のものに置き換える。
UA='Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot'
URL='https://example.com/article/'

curl -sL --compressed -A "$UA" -o gptbot.html -w 'HTTP %{http_code}\n' "$URL"
grep -c '記事の本文にある一文' gptbot.html   # 1以上なら、その一文はHTMLに入っている
本文の文字数とh1・h2・pの数まで出すなら、続けて次を実行する(Python 3が入っていれば動く)。
python3 - gptbot.html <<'EOF'
import re, sys
h = open(sys.argv[1], encoding="utf-8", errors="replace").read()
m = re.search(r"<body.*?</body>", h, re.S | re.I)
b = m.group(0) if m else ""
b = re.sub(r"<(script|style|noscript|template|svg)\b.*?</\1>", "", b, flags=re.S | re.I)
t = re.sub(r"<[^>]+>", "", b)
print("本文の文字数:", len(re.sub(r"\s+", "", t)))
for tag in ("h1", "h2", "p"):
    print(tag, len(re.findall(rf"<{tag}[\s>]", b, re.I)))
EOFこれは手早く数えるための簡易版で、本記事の表の数字を出したスクリプトとは数え方が少し違う(同じHTMLで数十〜数百文字ずれた)。見るべきは細かい数字ではなく、数千文字あるのか、ほぼ0なのかだ。0に近ければ、STEP 2の結果と合わせて「本文はJavaScriptで差し込まれている」と判断できる。
STEP 4:UAを変えて、受け取る中身が変わらないか見る(2分)
STEP 3のUAを、ふつうのブラウザのものや、OAI-SearchBot・PerplexityBotのものに変えて同じことをする。HTTPのステータスが403や503になる、文字数が大きく変わる場合は、セキュリティ設定やボット対策のサービスがAIのクローラーを別扱いしている可能性がある。今回の自社3サイトでは、8種類のUAすべてで200が返り、中身もほぼ同じだった。
| クローラー | UA(各社の公式ページに載っている例。バージョンは変わることがある) |
|---|---|
| GPTBot | Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot |
| OAI-SearchBot | Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.0.0 Safari/537.36; compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot |
| ChatGPT-User | Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; ChatGPT-User/1.0; +https://openai.com/bot |
| PerplexityBot | Mozilla/5.0 (compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot) |
| Perplexity-User | Mozilla/5.0 (compatible; Perplexity-User/1.0; +https://perplexity.ai/perplexity-user) |
STEP 5:robots.txtで止めていないか見る(1分)
ブラウザでhttps://自社ドメイン/robots.txtを開き、表のクローラー名が書かれているかを見る。書かれていなければ、User-agent: *のグループの指示がそのまま適用される。次の節で詳しく見る。
6. robots.txtの確かめ方と書き方の例
自社3サイトの状態
計測日のrobots.txtは、lifrell.co.jp・lifrell-tech.comとも、AIのクローラーの名前を一つも書いていなかった。どちらもUser-agent: *のグループで管理画面などの一部を止めているだけなので、表のクローラーはすべて、それ以外のページを読める状態だ。
婚活パラダイスはlifrell.co.jpの下の階層(/marriage/)にあるので、効くのはドメイン直下のrobots.txtだけだ。Googleは、robots.txtはサイトのいちばん上の階層に置く必要があり、下の階層にあるものはクローラーが確認しないと説明している(Google「robots.txt の書き方、設定と送信」)。実際、/marriage/robots.txt は404だった。
書き方の例
以下は例だ。学習には使わせず、検索・回答には表示してほしい場合の書き方で、そのまま貼る前に自社の方針と既存の記述を確かめる。
# ※例:学習用のクローラーだけ止め、検索・回答用は止めない場合
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://example.com/sitemap.xml
書くときの注意は3つ。
- 名前を書いたグループは、
*のグループと合算されない。Googleの説明では、クローラーは自分にいちばん具体的に当てはまるグループだけに従い、特定のクローラー向けのグループと*のグループは結合されない。たとえばUser-agent: OAI-SearchBotのグループを作って一部だけ止めると、*側に書いた管理画面の禁止はそのクローラーには効かなくなる。必要な行は各グループに書き写す。 - Google-Extendedを止めても、Google検索への掲載や順位には影響しないとGoogleは説明している。ただし、Geminiでのグラウンディングへの利用も対象に含まれるので、止めるかどうかは方針として決める。
- 反映には時間がかかる。OpenAIは、robots.txtの更新からOAI-SearchBot側の反映まで約24時間かかると説明している。
llms.txtについて
計測日には、lifrell-tech.comにはllms.txtがあり、lifrell.co.jpにはなかった(404)。Googleは、AI Overviews・AI Modeに出るために新しい機械可読ファイルやAI用のテキストファイルは要らないと説明している(同上)。llms.txtを置いても、ページのHTMLに本文がない状態を補えるわけではない。先に確かめるべきは本文のほうだ。
7. 本文が見えなかったときの直し方
| 見つかったこと | 直す方向 |
|---|---|
| 本文がHTMLにない(JavaScriptで差し込んでいる) | サーバー側で本文入りのHTMLを返す作り(サーバーサイドレンダリング、事前に静的なHTMLを書き出す作り、プリレンダリング)に切り替える。ノーコードのサービスや既製のテーマを使っている場合は、その設定やプランで対応できるかを提供元に確かめる |
| canonicalがHTMLにない・JavaScriptと値が違う | 元のHTMLにcanonicalを1つだけ入れる。JavaScriptで付けるなら同じ値にする(Googleの説明) |
| 「/」あり・なしの両方が200で表示される | どちらかに統一し、もう一方から301で転送する。サイトマップと記事内リンクも統一した側に合わせる |
| UAによって403などが返る | セキュリティ設定・CDN・ボット対策サービスの設定で、どのクローラーを止めているかを確かめる。止めたくないものは許可する |
| h1が複数ある | ページの主題を示すh1を1つにし、ほかはh2以下にする |
作りの切り替えは、サイトの規模や使っている仕組みによって手間が大きく変わる。まずは全ページを数えて、影響の大きさを把握してから判断するのが順番だ。
8. そのまま使えるチェックリスト
| 確かめること | 方法 | 合格の目安 |
|---|---|---|
| 本文の一文がHTMLにある | view-source: で検索 | 見つかる |
| JavaScriptを止めても本文が出る | DevToolsの「Disable JavaScript」 | 本文と見出しが表示される |
| 本文の文字数・h1・h2・p | STEP 3のcurlとPython | ブラウザで見える本文に近い文字数。h1は1つ |
| UAで中身が変わらない | STEP 4でUAを変える | すべて200で、文字数がほぼ同じ |
| canonicalがHTMLにある | view-source: で「canonical」を検索 | 1つだけあり、自分の正規URLを指す |
| 「/」あり・なしが統一されている | 片方のURLを開く | もう一方へ301で転送される |
| robots.txtの方針が意図どおり | /robots.txt を開く | 検索・回答用のクローラーを意図せず止めていない |
9. 正直に書く:この方法でわからないこと
- UAを名乗っただけで、本物のクローラーではない。本物は各社のIPアドレスから来るので、セキュリティ設定やCDNがIPで別扱いしていれば、受け取る中身は変わりうる。本物が来ているか、何を受け取ったかは、サーバーのアクセスログで確かめる必要がある。今回はログまでは見ていない。
- AIのクローラーがJavaScriptを実行しないことは、公式には確かめられていない。根拠はVercelの2024年12月の観測だ。各社の仕組みは変わりうる。この方法は「実行しなくても届くか」を確かめるもので、実行の有無そのものはわからない。
- 本文が見えても、引用されるとは限らない。各社とも引用元の選び方を公開していない。HTMLに本文があることは前提の一つにすぎず、内容の質や信頼性、検索での評価は別に問われる。
- GoogleのAI Overviewsには、この点検の意味は小さい。GooglebotはJavaScriptを実行するので、JavaScriptで本文を差し込むページでも、レンダリング後に読まれうる。この点検がとくに効くのは、ChatGPT・Claude・Perplexity向けだ。
- ClaudeBotのUAは代用。Anthropicの公式ページにはクローラーの名前しか載っておらず、UAの全文は確認できなかった。
- 8ページはサイト全体ではない。テンプレートが同じページなら結果は近いと考えられるが、作りの違うページ(LP、検索結果ページ、会員向けページなど)は個別に確かめる必要がある。
- 文字数にはナビゲーションやフッターも含む。本文だけを切り出した数字ではない。比べるときは、同じページのJavaScript実行後の文字数との割合で見るほうが確かだ。
10. よくある質問
Q. LLMO対策・AIO対策・GEO対策は、何から始めればいい?
A. 内容を書き直す前に、AIのクローラーが本文を受け取れているかを確かめる。受け取れていなければ、内容をいくら直しても届かないと考えられる。用語の違いや全体像はGEO・LLMO・AIO・AEO対策 完全ガイドとGEOとSEOの違いにまとめている。
Q. WordPressで作ったサイトなら、確かめなくていい?
A. 今回の3サイトはWordPressで、本文はHTMLに入っていた。ただし、テーマやプラグインの作りによっては本文の一部をJavaScriptで読み込むこともある。STEP 1とSTEP 3は数分で終わるので、主要なテンプレートごとに1ページずつ確かめておくと安心だ。
Q. GPTBotを止めると、ChatGPTに引用されなくなる?
A. OpenAIの説明では、GPTBotは学習用で、ChatGPTの検索に表示するのはOAI-SearchBotだ。OAI-SearchBotを止めると検索の回答に表示されなくなるとOpenAIは説明している。止める対象を取り違えないことが大事だ。
Q. Google-ExtendedのUAで取得してテストできる?
A. できない。Google-Extendedは独自のUAを持たず、robots.txtで指示を出すための名前だけだとGoogleは説明している。確かめるのはrobots.txtの記述だけでよい。
Q. 本文が0文字だったら、すぐにサイトを作り直すべき?
A. まず全ページを数えて範囲を把握し、使っているサービスの設定で直せるかを提供元に確かめる。作り直しは手間が大きいので、影響の大きいページ(流入の多い記事、サービスページ)から順に判断する。外部に頼む場合の費用感はAIO対策の外注費用、会社の選び方はGEO対策会社の比較が参考になる。
まとめ
LLMO・AIO・GEO対策の入口は、AIのクローラーが本文を受け取れているかの確認だ。ChatGPT・Claude・Perplexityのクローラーは、JavaScriptを実行するかを公式に示していない。だから基準は「JavaScriptを実行しないHTMLに本文があるか」の一つでよい。自社3サイト8ページでは本文はすべてHTMLに入っていた一方、JavaScriptで本文を表示する作りの別企業のオウンドメディアでは、全記事で本文が0文字だった。ブラウザで見て問題がなくても、この差は見えない。
今すぐできるアクション:
- 今日:主要な記事を1本選び、view-source: で本文の一文を検索し、DevToolsでJavaScriptを止めて表示する。あわせて /robots.txt を開き、AIのクローラーの名前が書かれているかを見る。
- 今週:テンプレートの違うページ(トップ・記事・サービスページ・LP)を1本ずつ、GPTBot・OAI-SearchBot・PerplexityBotのUAで取得し、本文の文字数・h1・canonical・ステータスを表にする。
- 来月:サーバーのアクセスログで、各社のクローラーが実際に来ているか、どのページで何を返したかを確かめる。本文が見えないページがあれば、影響の大きい順に直し方を決める。
本記事の自社サイトの数字は2026年11月7日 10:05〜10:08(日本時間)にmacOS 15.4.1・curl 8.7.1・Google Chrome 156で計測したもの、別企業の事例は2026年11月に計測したもの。ページの内容や各社のクローラーの仕様は変わることがある。各社の説明は2026年11月7日に確認した。最新の情報は、本文中の各社の公式ページで確認できる。
出典
- OpenAI「Overview of OpenAI Crawlers」(GPTBot・OAI-SearchBot・ChatGPT-UserのUAと役割、反映まで約24時間)
- Anthropic「Does Anthropic crawl data from the web, and how can site owners block the crawler?」(ClaudeBot・Claude-User・Claude-SearchBot)
- Perplexity「Perplexity Crawlers」(PerplexityBot・Perplexity-UserのUAと役割)
- Google「Google の一般的なクローラ」(Google-Extended)
- Google「JavaScript SEO の基本」(3段階の処理、canonical)
- Google「AI 機能とウェブサイト」(AI Overviews・AI Modeの条件)
- Google「robots.txt の書き方、設定と送信」(置き場所、グループの選ばれ方)
- Chrome DevTools「JavaScript を無効にする」
- Vercel「The rise of the AI crawler」(2024年12月17日、第三者の観測)
この記事を書いた人
自社サイトが「AIにどう見えているか」、全ページで確かめます
この記事の点検は、自社メディアと他社のオウンドメディアで実際に行ったものです。全ページを各社のクローラーとして取得し、本文・canonical・robots.txtの状態を表にして、直す順番の判断までお手伝いします。進め方と範囲は「AI検索対策(LLMO・AIO)の診断と立て直し」にまとめています。まずは無料でご相談ください。
運営:株式会社LIFRELL
