
ローカルLLMに必要なメモリは「モデルの重み+会話の分(KVキャッシュ)+余裕」で決まる。4bitに量子化したモデルなら、重みはパラメータ10億あたり約0.6GBが目安だ。この計算で見ると、VRAM 8GBのGPUならGemma 4 E4Bや8Bクラス、16GBならgpt-oss-20b、24GBならQwen3.8-27BやGemma 4 31Bの4bit版が候補になる。Macはメモリ全体をOSやほかのアプリと分け合うため、同じ数字のVRAMより余裕を見る。本記事では、OllamaとHugging Faceで公開されている実際のファイルサイズと、各モデルの設定ファイルから必要メモリを計算し、VRAM・メモリ別の早見表にまとめた。
この記事の前提:モデルの大きさはollama.comのタグ表示とHugging Faceの公式ファイル、GPUとMacのメモリ容量はNVIDIA・Appleの公式仕様ページで、2026年11月7日に確認した。会話の分のメモリは各モデルのconfig.jsonの値から計算した理論値で、実機での測定はしていない。実際の使用量は実行ツールの設定や画像入力の有無で増減する。
この記事でわかること
- VRAM・メモリ別に、4bit版で収まるモデルの早見表
- 必要メモリの計算式(重み・KVキャッシュ・余裕)と、その根拠の数字
- 会話を長くするとメモリがどれだけ増えるか
- NVIDIAのGPUとMacのメモリ構成の選び方
- 自分のPCで確かめる手順と、よくある勘違い
 執筆:佐藤 祐介(株式会社LIFRELL 代表取締役/業界歴15年・マーケティング支援 累計500社以上)
1. 結論:VRAM・メモリ別の早見表
4bit版のファイルがVRAMより数GB小さければ、短い会話なら収まる目安になる。長い資料を読ませるなら、さらに会話の分を足して考える。
| VRAM/メモリ | 該当する主なGPU(公式仕様) | 4bit版で候補になるモデル(ファイルの大きさ) |
|---|---|---|
| 8GB | RTX 5060、RTX 5060 Ti(8GB版)、RTX 4060 | Gemma 4 E2B(4.6GB)、LLM-jp-4.1 8B(5.5GB)、Gemma 4 E4B(6.6GB) |
| 12GB | RTX 5070、RTX 3060(12GB版) | Gemma 4 12B(8.0GB、QAT版は7.2GB) |
| 16GB | RTX 5080、RTX 5070 Ti、RTX 5060 Ti(16GB版)、RTX 4060 Ti(16GB版) | gpt-oss-20b(14GB)、Gemma 4 12Bの8bit版(13GB) |
| 24GB | RTX 4090 | Qwen3.8-27B(18GB)、Gemma 4 26B A4B(18GB)、Gemma 4 31B(20GB)、LLM-jp-4.1 33B(20.41GB) |
| 32GB | RTX 5090 | 24GBの候補を長い会話で、Qwen3.6-35B-A3B(23GB) |
| 128GB級 | Mac(M5 Max 128GB)、NVIDIA DGX Spark(128GB) | gpt-oss-120b(65GB)、Qwen3.8-27Bの8bit版(30GB) |
出典:モデルの大きさはollama.comの各タグ(q4_K_Mなどの4bit版)とLLM-jp公式GGUF、GPUのメモリはNVIDIA公式仕様(RTX 5060、RTX 5070、RTX 5080、RTX 5090、RTX 4090、RTX 4060、RTX 3060、DGX Spark)。表の振り分けは本記事の計算による目安で、動作を保証するものではない。
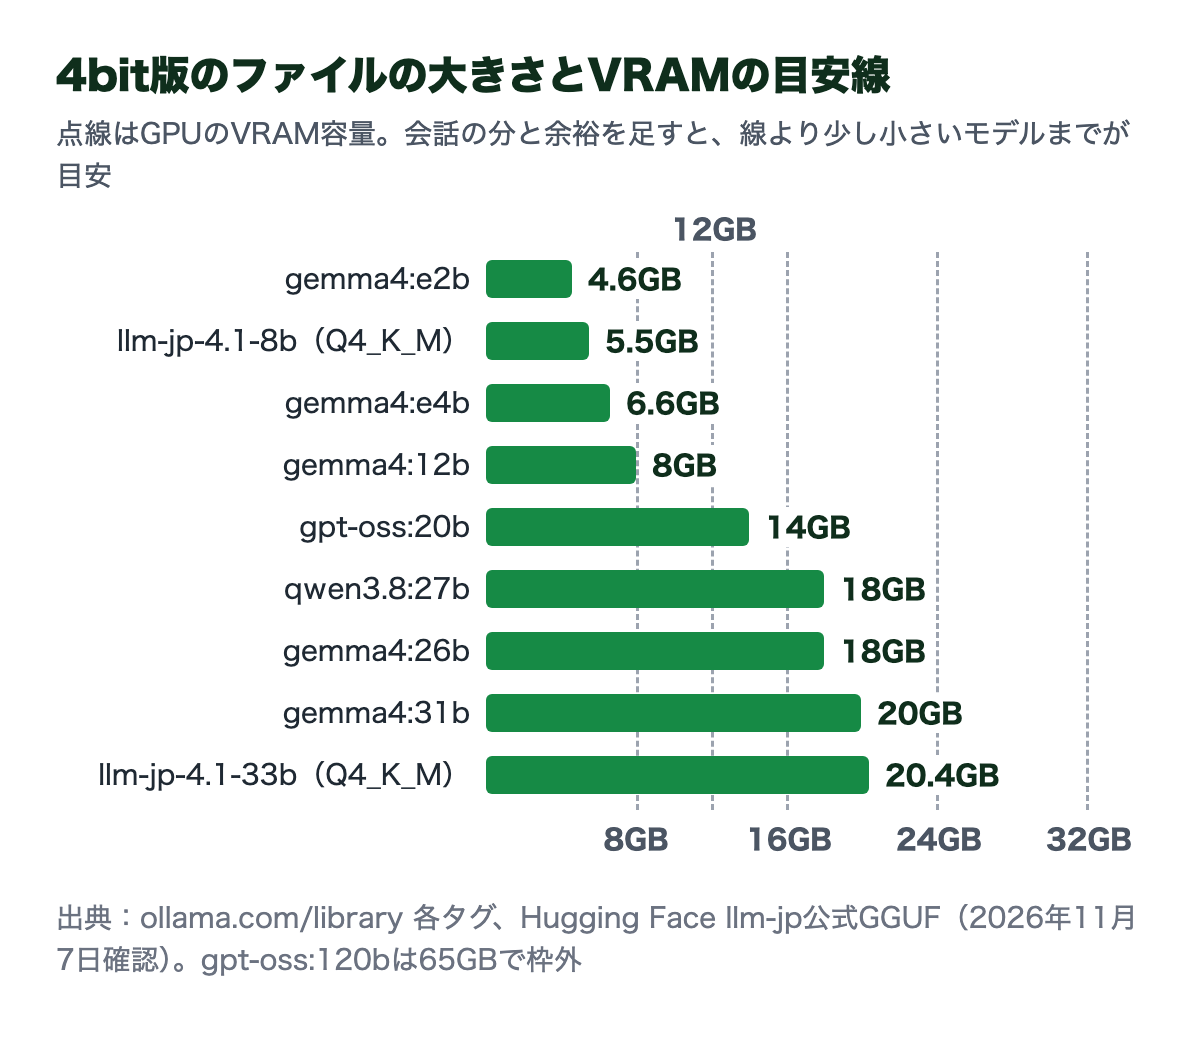
図の要点:8GBに収まるのはGemma 4 E4Bまで、16GBならgpt-oss-20bまで、24GBで27B〜33Bクラスの4bit版が入る。
同じモデルでもファイルの大きさに幅がある:たとえばOllamaの gemma4:e2b は「4.6GB〜7.5GB」と表示される。4bitのq4_K_M版が4.6GB、Mac向けのMLX版が7.5GBで、配布形式によって大きさが変わるためだ(gemma4 tags)。Ollamaの公式クイックスタートは、Gemma 4 E2Bについて「ダウンロードは約7.2GB、8GBのVRAMを推奨」と書いている。
2. 必要メモリの計算式
必要なメモリは「重み+KVキャッシュ+余裕」の3つを足したものだ。モデルのファイルがVRAMに入るだけでは足りない。
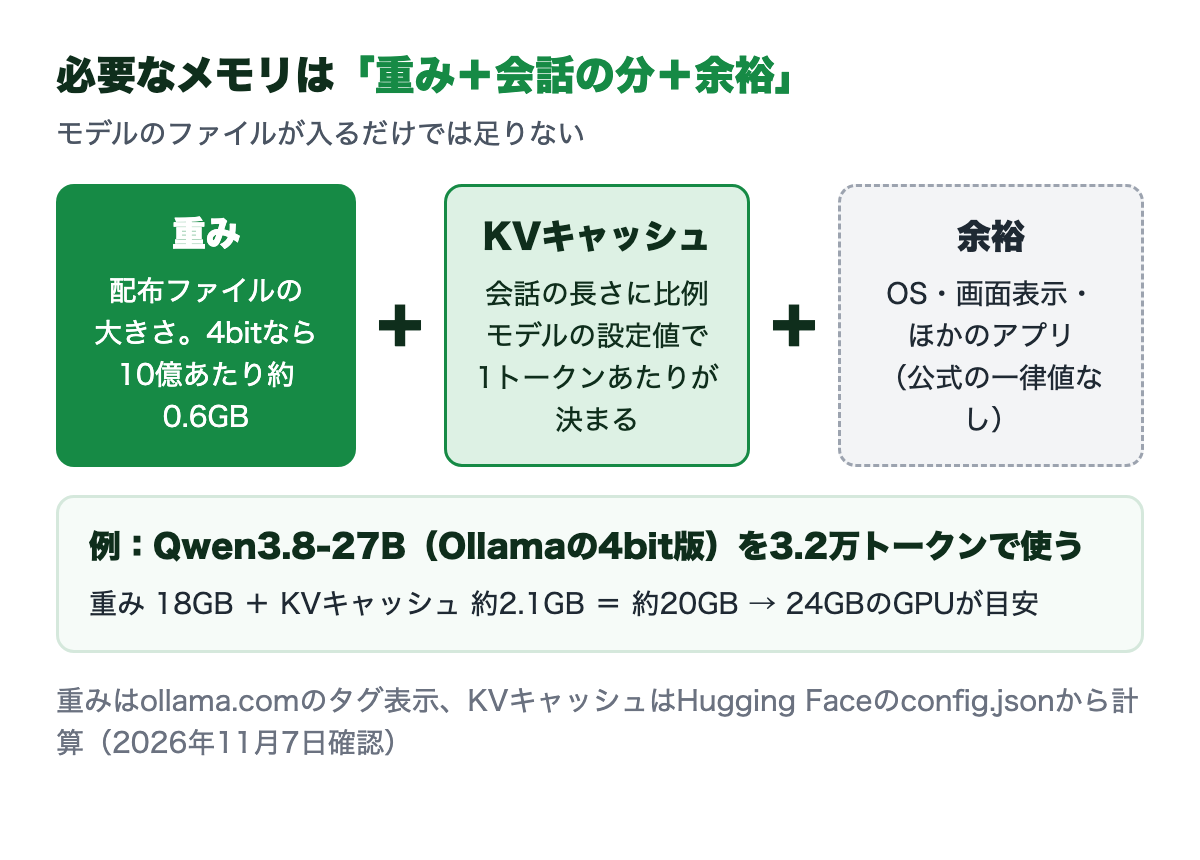
図の要点:重みは配布ファイルの大きさ、KVキャッシュは会話の長さに比例し、ほかにOSや画面表示の分の余裕が要る。
重み:パラメータ数×係数
重みとは、モデルが学習で身につけた数値の集まりのこと。量子化とは、その数値を少ないビット数に丸めてファイルを小さくする方式のこと。公式に配布されているファイルの大きさをパラメータ数で割ると、係数は次のようになる。
| モデル(パラメータ数) | 形式 | ファイルの大きさ | 10億あたり |
|---|---|---|---|
| LLM-jp-4.1 8B(85.9億) | Q4_K_M/BF16 | 5.50GB/17.19GB | 0.64GB/2.00GB |
| LLM-jp-4.1 33B(332.2億) | Q4_K_M/BF16 | 20.41GB/66.45GB | 0.61GB/2.00GB |
| Gemma 4 31B(307億) | Google公式QAT q4_0 | 17.65GB(画像用ファイル1.2GBは別) | 0.57GB |
| Gemma 4 12B(119.5億) | Google公式QAT q4_0 | 6.98GB(画像用0.18GBは別) | 0.58GB |
| Qwen3.8-27B(約278億) | Ollama q4_K_M/q8_0/bf16 | 18GB/30GB/56GB | 0.65GB/1.08GB/2.02GB |
出典:Hugging Faceのllm-jp-4.1-33b-thinking-gguf、gemma-4-31B-it-qat-q4_0-gguf、gemma-4-12B-it-qat-q4_0-ggufのファイル一覧、qwen3.8 tags。パラメータ数は各モデルカード(Qwen3.8-27BはHugging Faceのファイル情報の合計で、画像処理部分を含む)。
まとめると、4bitなら10億あたり約0.57〜0.65GB、8bitなら約1.1GB、BF16(16bit)なら2.0GBになる。たとえば70億(7B)のモデルを4bitで使うなら、重みだけで約4〜4.6GBと見積もれる。
MoEモデルも「総パラメータ」で見積もる
MoE(Mixture of Experts)とは、たくさんの「専門家」の中から一部だけを使って答えを作る仕組みのこと。使う部分が少ないので速くなるが、ファイル全体はメモリに載せる必要がある。Gemma 4 26B A4Bは総パラメータ252億・動く部分38億だが、Ollamaの4bit版は18GBで、同じくらいの総パラメータを持つQwen3.8-27B(18GB)と変わらない(Gemma 4モデルカード、gemma4 tags)。「A4B」の数字だけを見て、4Bのモデルと同じメモリで動くと考えないようにする。
3. 会話が長いほど増える分(KVキャッシュ)
KVキャッシュとは、それまでの会話や読ませた資料を覚えておくためのメモリのこと。会話の長さ(トークン数)に比例して増え、モデルによっては重みと同じくらいまで膨らむ。
1トークンあたりの大きさは、モデルの設定ファイル(config.json)にある値から次の式で計算できる。
1トークンあたり = 2(KとV) × 全体を見る注意層の数 × KVヘッド数 × ヘッド次元 × 2バイト(16bitの場合)| モデル | 1トークンあたり | 4,096トークン | 32,768トークン | 65,536トークン |
|---|---|---|---|---|
| LLM-jp-4.1 8B(全32層、KVヘッド8、次元128) | 128KiB | 0.54GB | 4.29GB | 8.59GB |
| LLM-jp-4.1 33B(全64層、KVヘッド8、次元128) | 256KiB | 1.07GB | 8.59GB | 17.18GB |
| LLM-jp-4.1 32B-A3B(全32層、KVヘッド4、次元128) | 64KiB | 0.27GB | 2.15GB | 4.29GB |
| Qwen3.8-27B(全体注意16層、KVヘッド4、次元256) | 64KiB | 0.27GB | 2.15GB | 4.29GB |
| gpt-oss-20b(全体注意12層、KVヘッド8、次元64) | 24KiB | 0.10GB | 0.81GB | 1.61GB |
出典:各モデルのconfig.json(llm-jp-4.1-33b-thinking、Qwen3.8-27B、gpt-oss-20bなど)から本記事で計算した理論値。Qwen3.8-27Bの残り48層は固定サイズの状態を持つ線形注意で、gpt-oss-20bの残り12層は直近128トークンだけを見る層のため、ほぼ増えない。Gemma 4は層ごとに形が異なる特殊な構成のため、本記事では計算していない。
この表から、同じ「30B級」でも会話の分は大きく違うことがわかる。LLM-jp-4.1 33Bは4bit版20.41GBに3.2万トークン分の8.59GBを足すと約29GBになり、24GBのGPUには収まらない。一方、Qwen3.8-27Bは18GB+2.15GBで約20GBに収まる計算だ。
Ollamaの初期設定に注意
Ollamaは、VRAMが24GiB未満なら4K、24〜48GiBなら32K、48GiB以上なら256Kトークンを初期のコンテキスト長にする(Context length)。メモリの大きいMacやGPUでは、何も設定しなくても会話の分が大きく確保される。Qwen3.8-27Bを256Kで使うと、上の式で約17.2GBが重みとは別に必要になる。使い方に合わせて短く設定し、ollama ps で実際の値を確かめる。
会話の分を減らす方法もある。Ollamaでは環境変数 OLLAMA_KV_CACHE_TYPE を q8_0 にすると約半分、q4_0 にすると約4分の1になる。ただし精度が少し落ちることがあり、Flash Attentionが有効な場合に使える(Ollama FAQ)。
4. GPU(Windows・Linux)で選ぶ
NVIDIAのGPUで選ぶなら、見るべきはVRAMの容量だ。同じ製品名でも8GB版と16GB版があるモデルは、購入前に容量を確かめる。
| GPU | VRAM(NVIDIA公式) |
|---|---|
| GeForce RTX 5090 | 32GB |
| GeForce RTX 5080 | 16GB |
| GeForce RTX 5070 Ti/5070 | 16GB/12GB |
| GeForce RTX 5060 Ti/5060 | 16GBまたは8GB/8GB |
| GeForce RTX 4090 | 24GB |
| GeForce RTX 4060 Ti/4060 | 16GBまたは8GB/8GB |
| GeForce RTX 3060 | 12GBまたは8GB |
出典:NVIDIA各製品の仕様ページ(2026年11月7日確認)。
- VRAMが足りないとき:Ollamaはメインメモリも使って動かせるが、応答は遅くなる(Quickstart)。
ollama psで「48%/52% CPU/GPU」のように表示されたら、一部がCPU側にある状態だ。 - GPUを2枚載せた場合:Ollamaは1枚に収まるなら1枚に載せ、収まらない場合だけ複数に分ける(FAQ)。
- 対応GPU:OllamaはNVIDIAのCompute Capability 5.0以上・ドライバー550以降に対応する。AMDはRadeon RX 9070 XTや7900 XTX、Ryzen AI Max+ 395など、ROCm v7で動く製品が一覧にある(Hardware support)。
- メインメモリ:LM StudioはWindowsで16GB以上のRAMと4GB以上のVRAMを推奨している(LM Studio System Requirements)。
5. Macで選ぶ(ユニファイドメモリ)
Apple シリコンのMacは、CPUとGPUが同じメモリ(ユニファイドメモリ)を使う。そのため、搭載メモリが大きければ、市販のGPUのVRAM(最大32GB)を超える大きさのモデルも載せられる。
ユニファイドメモリとは、CPUとGPUが1つのメモリを共有する仕組みのこと。OllamaはMシリーズのGPUをMetalで使い、Intel MacではCPUだけで動く(Ollama macOS)。LM StudioはApple シリコンとmacOS 14以降が必要で、16GB以上を推奨し、8GBのMacでは小さいモデルと短いコンテキストにとどめるよう書いている(LM Studio)。
| Mac(2026年11月7日の構成) | 選べるメモリ | 4bit版の目安(本記事の計算) |
|---|---|---|
| MacBook Air(M5) | 16GB/24GB/32GB | 16GB:Gemma 4 E4B(6.6GB)、Gemma 4 12B(MLX版7.7GB)。24GB:gpt-oss-20b(14GB)。32GB:Qwen3.8-27B(18GB) |
| Mac mini(M6/M5 Pro) | M6:16〜32GB、M5 Pro:24〜64GB | 48〜64GB:Qwen3.8-27Bの8bit版(30GB)、Gemma 4 31Bの8bit版(34GB) |
| MacBook Pro(M6/M5 Pro/M5 Max) | 16GB〜128GB | 128GB:gpt-oss-120b(65GB) |
| Mac Studio(M5 Max/M5 Ultra) | M5 Max:48〜128GB、M5 Ultra:256GB/512GB | 256GB以上:総3,200億パラメータ級のMoE(GLM-5.3-Flashなど。4bitで約190GBの計算) |
出典:Apple公式の仕様ページ(MacBook Air、Mac mini、MacBook Pro、Mac Studio)。モデルの大きさはollama.comのタグ表示。GLM-5.3-Flashの総パラメータ(3,200億)はモデルカードの記載で、4bitの大きさは係数0.6を掛けた計算値。
- GPUに回せる割合は公表されていない:ユニファイドメモリのうちGPUが使える上限について、Appleの公式な割合の記載は見当たらない。OSやブラウザも同じメモリを使うため、搭載量いっぱいのモデルは選ばない。
- Mac向けの形式:OllamaにはMac向けのMLX版タグ(例:
gemma4:12b-mlx7.7GB、qwen3.8:27b-mlx18GB)がある。MLXとは、AppleがMac向けに公開している機械学習の仕組みのこと。 - メモリ帯域:Appleはチップごとにメモリ帯域を公表している(M5のMacBook Airは153GB/s、40コアGPUのM5 Maxは614GB/s)。一般に、文章を1文字ずつ生成する速さはメモリ帯域の影響を受けやすいが、本記事では速度を測っていない。
Macを常時動かすサーバーとして使う場合の設定はMac miniでAIを常時稼働させる方法にまとめている。
6. CPU・メインメモリ・ストレージ
GPUがなくてもCPUだけで動かせるが、遅くなる。ストレージはモデル1つで数GB〜数十GBを使うため、空きを先に確保しておく。
- CPU:Ollamaは複数のCPU向けライブラリを持ち、AVX2対応のCPUが最も速く、次にAVXとしている(Troubleshooting)。LM StudioはWindows(x64)でAVX2対応を必須にしている。
- ストレージ:Windows版Ollamaは本体だけで4GB以上の空きが必要で、モデルは数十〜数百GBになりうる(Windows)。たとえばGemma 4 31BのBF16版は63GBある。
7. 自分のPCで確かめる手順
手元のVRAMを確認し、「VRAM − 会話の分 − 余裕」に収まる4bit版から試すのが確実だ。最後は実際に読み込んで、どこに載ったかを見る。
- VRAM・メモリを確認する:Windowsはタスクマネージャーの「パフォーマンス」→「GPU」の専用GPUメモリ、NVIDIAなら
nvidia-smi、MacはAppleメニューの「このMacについて」で見る。 - 使い方を決める:短い質問中心なら4Kトークン、長い資料やエージェントなら3万〜6万トークン以上と見積もる。
- モデルを選ぶ:「4bit版のファイル+3章の会話の分」がVRAMより小さいものを選ぶ。
- 読み込んで確認する:Ollamaなら
ollama run モデル名のあと、別の画面でollama psを実行し、SIZE・PROCESSOR・CONTEXTを見る。「100% GPU」なら全体がGPUに載っている。 - 収まらなければ下げる:コンテキストを短くする、KVキャッシュを
q8_0にする、1段小さいモデルにする、の順に試す。
Ollamaの入れ方とコマンドはOllamaの使い方、画面で操作するLM Studioの手順はローカルLLMの始め方(LM Studio)で解説している。
8. よくある勘違いとつまずき
多いのは「ファイルが入れば動く」「MoEなら軽い」と考えて、会話の途中で遅くなるケースだ。
| 症状・勘違い | 実際 | 対処 |
|---|---|---|
| 最初は速いが、長い資料を入れると急に遅くなる | 会話の分(KVキャッシュ)が増えてGPUからあふれた | コンテキストを短くする、資料を分ける、KVキャッシュをq8_0にする |
| 「A4B」「A3B」なら小さいメモリで動くはず | メモリは総パラメータで決まる(Gemma 4 26B A4Bは18GB) | ファイルの大きさで判断する |
| 大容量のMacなのにメモリ不足になる | Ollamaは48GiB以上だと初期のコンテキストを256Kにする | 使う長さに合わせて num_ctx を設定する |
| Macでほかのアプリが重くなる | OSやアプリと同じメモリを分け合っている | 1段小さいモデルにする、使わないときは ollama stop で下ろす |
| RTX 5060 Tiを買ったのに16GBのモデルが入らない | 8GB版だった | 購入前に仕様のメモリ容量を確かめる |
9. 欠点・制限事項(わからないこと)
- 本記事の数字は計算値で、実測ではない。実行ツールは重みと会話の分のほかに作業用のメモリを使い、その量は公式に一律の数字がない。画像を読ませる場合は画像処理用のファイル(Gemma 4 31Bで1.2GBなど)も加わる。
- Gemma 4の会話の分は計算していない。層ごとに形が異なり、実行ツールでの扱いが公式に説明されていないためだ。
- MacのGPUに回せる割合はAppleの公式な記載が見当たらない。
- 速度は測っていない。同じメモリ量でも、GPUの世代やメモリ帯域で生成の速さは変わる。
- GBとGiBの違い:ファイルの大きさは10億バイト単位(GB)、Ollamaのコンテキストの区切りは2の30乗単位(GiB)で書かれている。1GiBは約1.07GBだ。
- 量子化による品質の変化はモデルと用途によって違い、一律の数字は公式に出ていない。
10. よくある質問
メモリ8GBのノートPCでもローカルLLMは動く?
小さいモデルなら動く。4bit版で5GB前後のGemma 4 E2BやLLM-jp-4.1 8Bが候補だ。ただしOSやブラウザも同じメモリを使うため、会話は短めにする。LM Studioは8GBのMacについて、小さいモデルと短いコンテキストにとどめるよう案内している。
MacとNVIDIAのGPU、ローカルLLMにはどちらが向いている?
動かしたいモデルの大きさで決まる。市販のGeForceのVRAMは最大32GB(RTX 5090)なので、65GBのgpt-oss-120bのような大きいモデルは128GB級のMacなどが現実的だ。24GB以内に収まるモデルを使うならGPUでもMacでも動く。速さは本記事では測っていない。
MoEモデルなら少ないメモリで動く?
動かない。MoEは使う部分が少ないので速くなるが、ファイル全体をメモリに載せる必要がある。Gemma 4 26B A4Bの4bit版は18GBで、同じくらいの総パラメータを持つQwen3.8-27Bと同じ大きさだ。
4bitに量子化すると品質は落ちる?
落ちる可能性はあるが、程度はモデルと用途によって違い、一律の数字はない。gpt-ossは量子化した状態で評価されており、Gemma 4には量子化を前提に学習したQAT版がある。気になる場合は、同じ質問で4bit版と8bit版を比べる。
GPUがないPCでも動く?
CPUとメインメモリだけでも動くが、応答は遅くなる。Ollamaの公式クイックスタートも、VRAMが足りない場合はメインメモリを使えるが遅くなると説明している。
まとめ
ローカルLLMの必要スペックは、「4bit版のファイルの大きさ+会話の分+余裕」で見積もれる。4bitなら10億パラメータあたり約0.6GBで、8GBのVRAMならGemma 4 E4Bや8Bクラス、16GBならgpt-oss-20b、24GBならQwen3.8-27BやGemma 4 31Bが目安になる。会話の分はモデルの構造で大きく違い、全層で注意を使う33Bクラスでは3.2万トークンで8GBを超える。
今すぐできるアクション:
- 今日:自分のPCのVRAM(Macならメモリ)を確認し、1章の表で候補のモデルを2つ選ぶ。
- 今週:小さいほうから読み込み、
ollama psで「100% GPU」かとコンテキストの値を確かめる。使う資料の長さでも試す。 - 来月:業務で必要な会話の長さと同時に使う人数から必要メモリを計算し直し、PCやGPUを買い足すか、クラウドのAPIを併用するかを決める。
本記事の内容は、2026年11月7日にollama.com、Ollama公式ドキュメント、Hugging Faceの各モデルのファイル・設定、NVIDIA・Apple・LM Studioの公式ページで確認したもの。メモリの数字は公開値からの計算で、実機の測定値ではない。製品の構成やモデルの配布ファイルは変わることがある。
関連記事
- Ollamaの使い方|インストール・日本語モデル・エラー対処
- 日本語に強いオープンモデル比較|Gemma 4・Qwen・gpt-oss・LLM-jp
- ローカルLLMの始め方|LM Studioの使い方・必要スペック・モデルの選び方
- LM StudioとOllamaの違いを比較
- Mac miniでAIを常時稼働させる方法
- Qwen3.8とは?ローカルでの動かし方・ライセンス
- Gemmaとは?Gemma 4の使い方と5モデル比較
- DeepSeek V4とは?料金・性能・セキュリティリスク
出典
- Ollama:gemma4/qwen3.8/qwen3.6/gpt-ossの各タグ、公式ドキュメント(Quickstart、Context length、FAQ、Hardware support、macOS、Windows、Troubleshooting)(2026年11月7日確認)
- Hugging Face モデルカード・設定・ファイル一覧:llm-jp-4.1-33b-thinking、llm-jp-4.1-8b-thinking-gguf、llm-jp-4.1-33b-thinking-gguf、llm-jp-4.1-32b-a3b-thinking-gguf、gemma-4-12B-it、gemma-4-31B-it-qat-q4_0-gguf、Qwen3.8-27B、gpt-oss-20b、GLM-5.3-Flash(2026年11月7日確認)
- NVIDIA公式仕様:RTX 5090、RTX 5080、RTX 5070 Family、RTX 5060 Family、RTX 4090、RTX 4060 Family、RTX 3060 Family、DGX Spark(2026年11月7日確認)
- Apple公式仕様:MacBook Air、Mac mini、MacBook Pro、Mac Studio(2026年11月7日確認)
- LM Studio System Requirements(2026年11月7日確認)
この記事を書いた人
ローカルLLMを業務で使う前の「機器・モデル・運用」を相談できます
使いたい業務と会話の長さから必要なメモリを見積もり、PCやGPU・Macの構成、モデルの選定、社内データを外に出さない運用ルールまで、ご相談をお受けします。まずは無料でご相談ください。
運営:株式会社LIFRELL
