AIナレーション(合成音声)が「片言っぽい」「ぶつ切りで不自然」に聞こえる。よくある悩みだが、原因を勘で探すと遠回りになる。本記事では、LIF Techを運営する株式会社LIFRELLが動画広告のナレーション制作で実際にぶつかった「片言問題」を、音声を数値で測って原因を特定し、原稿の書き方と選び方で直した記録として公開する。外れた仮説も含めて、試行錯誤をそのまま書く。後半では、AIナレーションを自然にする一般的な方法もまとめて解説する。
この記事の前提:実例は2026年9〜10月に、あるオンラインサービスの動画広告(縦型・20〜40秒)のナレーションを作ったときの記録。音声合成はHiggsfieldで使えるQwen系の音声合成モデル(日本語・女性の声)を使った。クライアント名は伏せている。結果は使った音声合成モデルや声によって変わりうる。
この記事でわかること
- AIナレーションが片言に聞こえた本当の原因(実測データ)
- 外れた3つの仮説と、当たった「間(無音)」という見方
- すぐ使える原稿の書き方4つ(体言止め・数字・助数詞・固有名詞)
- 何本か生成して「無音の割合」で自動で選ぶ方法(スクリプトの考え方)
- AIナレーションを自然にする一般的な方法と、やってはいけない後処理
- VOICEVOXで解説動画を量産したときの読み対策と、尺ごとの文字数の目安
 執筆:佐藤 祐介(株式会社LIFRELL 代表取締役/業界歴15年・マーケティング支援 累計500社以上)
結論:片言の正体は「音」ではなく「間(無音)の入り方」だった
先に結論をまとめる。今回のケースでは、AIナレーションが片言に聞こえる原因は、発音や音の高さではなく、文の途中に入る無音(間)の多さだった。対策は次の4つで、どれもすぐに試せる。
| 対策 | 中身 | 効果(実測) |
|---|---|---|
| ① 体言止めを並べない | 「〜で。〜も。」と名詞で切らず、「〜ます/〜です」で閉じて読点でつなぐ | 200ミリ秒を超える無音が10回→6回、無音の合計が4.33秒→2.30秒 |
| ② 数字はかなで書かない(助数詞の「人」は例外) | 算用数字のままにする。ただし「人」は「じん」と読まれることがあるので、原稿だけ「にん」と書く | かなで書くと平板に読まれた。算用数字のままで正しく読まれた |
| ③ 何本か生成して、無音の少ない回を選ぶ | 同じ原稿でも生成ごとに間の取り方が変わる。数値で比べて一番流れている回を採用する | 同じ原稿で、無音が6回の回と11回の回が出た |
| ④ 固有名詞は原稿だけ表記を変える | ひらがなのブランド名はイントネーションが崩れたため、原稿だけカタカナにした(画面の文字はそのまま) | 聴き比べでカタカナ版を採用。この1回の比較では無音も8回→6回に減った |
1. AIナレーションが不自然に聞こえる主な原因
一般に、AIナレーションが不自然に聞こえる原因は、次のどれか(または複数)であることが多い。
| 原因 | 聞こえ方 | 主な直し方 |
|---|---|---|
| 読み間違い | 漢字・数字・固有名詞を違う読み方で読む | 原稿の表記を変える(ひらがな・カタカナ・言い換え)、読みの辞書を登録する |
| イントネーション(アクセント) | 単語の高低が不自然、方言のように聞こえる | 表記を変える、語の区切りを変える、声を変える |
| 間(無音)の入り方 | ぶつ切り、片言、息継ぎが多すぎる | 文の作りを変える、何本か生成して選ぶ、ポーズの指定ができるなら調整する |
| 速度 | 早口すぎて聞き取れない、遅すぎて間延びする | 読む速さの設定、原稿の文字数を動画の尺に合わせる |
| 感情・抑揚の不足 | 棒読み、平坦 | 話し方を指示できるモデルなら指示文を足す、声の種類を変える |
今回ぶつかった「片言っぽさ」は、聞いた印象だけだとイントネーションの問題に思えた。しかし実際に測ってみると、原因は3番目の「間の入り方」だった。
2. 実例:動画広告のナレーションが片言に聞こえた
作っていたのは、オンラインサービスの縦型動画広告だ。画面に大きな文字を出し、女性の声のナレーションを重ねる構成で、尺は20〜30秒前後。原稿は、広告らしく短いフレーズを重ねる形で書いていた。
【最初の原稿のイメージ(体言止めが続く形)】
スマホ一つで。毎日10分。復習も予習も。
生成したナレーションを聞くと、内容は正しく読めているのに、どこか「片言」に聞こえる。発音の問題なのか、声の問題なのか、聞いただけでは判断がつかなかった。
3. 試行錯誤:外れた3つの仮説と、当たった「間」
外れた仮説
最初は「音そのもの」に原因があると考え、次の3つを順に疑って測った。
- 促音(「っ」)の長さが不自然なのではないか
- 音の高さの幅(抑揚の大きさ)が狭すぎる、または広すぎるのではないか
- 1音ごとの長さのばらつきが大きいのではないか
どれも、聞いた印象とつながりそうに思えたが、3回とも片言さの説明にはならなかった。「それらしい原因」を1つずつ潰していくやり方は、ここで行き詰まった。
当たった仮説:無音(間)の入り方
視点を変えて、音ではなく音と音のあいだ、つまり無音の入り方を測った。すると、片言に聞こえるナレーションほど、文の途中に短い無音がたくさん入っていることが分かった。人が話すときは一息で続けるところで、合成音声が細かく息継ぎをしているような状態だ。
測った指標は次の3つだ。
| 指標 | 意味 | 良い方向 |
|---|---|---|
| 無音の回数(200ミリ秒超) | 文の途中に入る、はっきりした間の数 | 少ないほど流れて聞こえる |
| 無音の割合 | 無音の合計秒数 ÷ 全体の秒数 | 小さいほどよい(一番効いた指標) |
| 平均フレーズの長さ | 無音で区切られた「ひと息」の平均の長さ | 長いほどよい(補助の指標) |
原稿を直したら、数字がはっきり変わった
体言止めが続く原稿を、「〜ます/〜です」で閉じて読点でつなぐ形に書き直し、同じ声・同じ速さで生成して比べた。
| 200ミリ秒超の無音 | 無音の合計 | 平均フレーズ | |
|---|---|---|---|
| 体言止めの原稿 | 10回 | 4.33秒 | 0.37秒 |
| 書き直した原稿 | 6回 | 2.30秒 | 0.44秒 |
合成音声は、文が切れるたびに音の高さを下げて区切りを付ける。体言止めを並べると、その「区切り」が短い間隔で何度も入り、ぶつ切りに聞こえる。これが今回の片言の正体だった。
同じ原稿でも、生成のたびに間が変わる
もう1つ分かったのが、同じ原稿・同じ速さでも、生成するたびに間の取り方が変わることだ。同じ原稿で5本生成したところ、200ミリ秒超の無音が6回の回もあれば、11回の回もあった。片言に聞こえるのは、無音が多い回だった。
つまり、原稿を直したうえで何本か生成し、無音の少ない回を選ぶのが確実だ。使った音声合成では1本あたりのコストが小さかった(1本0.03クレジット)ので、毎回4本ほど生成して選ぶ運用にした。
数字・助数詞・固有名詞でも、書き方で読みが変わった
- 数字:「にせんごひゃく」とかなで書くと、平板に読まれた。「2500」と算用数字のままのほうが自然だった
- 助数詞の「人」:「2500人」は「にせんごひゃくじん」と読まれることがあった。原稿だけ「2500にん」と書き、画面の文字は「2,500人」のままにした。なお、文字起こしでは「にん」も「じん」も「人」と表示されるため、この確認だけは耳で聞く必要があった
- ひらがなのブランド名:イントネーションが崩れた。表記の違う4案(ひらがな・カタカナ・後ろに空白・助詞を挟む)を作って聴き比べ、原稿だけカタカナにする案を採用した。画面に出る文字はひらがなのまま。1回の比較だが、カタカナ版は無音も8回/3.66秒→6回/2.59秒に減った
読む速さは「字/秒」で管理した
速さは、原稿の文字数 ÷ ナレーションの秒数(字/秒)で管理した。画面に大きな文字を出す型の動画では、参考にした動画が約5.8字/秒だったため、6.0〜6.6字/秒を目安にした。短く歯切れのよい型では6.4〜7.8字/秒に設定し、7.04字/秒の回を採用した。同じ原稿でも生成するたびに長さが15.3〜19.3秒とばらついたので、ここでも複数本から選ぶ方法が効いた。
また、話し方を文章で指示できる使い方では、「ぽつぽつと」「小さめの声で淡々と」といった指示を足すと、速さが4.0〜7.3字/秒に落ち、インタビュー風の自然な間が出た。
原稿の書き換え例(ビフォーアフター)
今回のルールで原稿を直すと、たとえば次のようになる(説明のための例文)。
| 直す前(片言になりやすい) | 直した後 | 直したポイント |
|---|---|---|
| スマホ一つで。毎日10分。復習も予習も。 | スマホ一つで、毎日10分から学べます。苦手なところは復習して、得意なところは予習できます。 | 体言止めをやめ、「〜ます」で閉じて読点でつなぐ |
| 累計にせんごひゃくにん以上が利用。 | これまでに、2500にん以上が利用しています。 | 数字は算用数字に戻し、助数詞だけ「にん」と書く。画面の文字は「2,500人以上」 |
| 今だけ。資料請求無料。入会金ゼロ円。 | いまなら資料請求は無料で、入会金もかかりません。 | 短いフレーズの連続を1文にまとめる |
広告の画面の文字は短く切ったほうが読みやすいが、耳で聞く原稿は、文としてつながっているほうが自然に聞こえる。画面の文字とナレーションの原稿を同じ文にしないことが、片言を防ぐいちばんの近道だった。
話し方を指示するときの例
話し方を文章で指示できる音声合成では、次のような指示で雰囲気を変えられた。指示は短く、具体的に書くほうが効いた。
【インタビュー風(利用者の声など)】
小さめの声で淡々と、ぽつぽつと話してください。言葉を選びながら話す感じで。

【広告のナレーション(明るめ)】
明るく、はっきりと。語尾を下げすぎず、一定のテンポで読んでください。
インタビュー風の指示では、読む速さが4.0〜7.3字/秒に落ち、取材映像のような自然な間が出た。一方で、広告のナレーションに同じ指示を使うと間延びするので、動画の型ごとに指示を分けている。
4. 「無音の割合」で自動的に選ぶ仕組み(図解)
毎回耳で何本も聞き比べるのは大変なので、生成から選ぶところまでを小さなスクリプトにした。流れは次のとおりだ。
測り方の考え方
- 音声を1チャンネル・16kHzに変換し、10ミリ秒ごとに音の大きさを計算する
- 一番大きい音の2%などを目安に「無音」とみなす境目を決め、200ミリ秒以上続く無音を数える
- 無音で区切られた「声が出ている区間」の長さの平均を、平均フレーズの長さとする
- 点数は「平均フレーズの長さ − 2 ×(無音の秒数 ÷ 全体の秒数)」のように、無音の割合を重く見る形にした
この程度の計算なら、ffmpegで音声を取り出し、Pythonで数十行書けば作れる。大事なのは計算の細かさより、「何が片言さに効いているか」を測れる指標を見つけることだった。
5. AIナレーションを自然にする方法(まとめ)
原稿でできること
- 体言止めを並べず、「〜ます/〜です」で閉じて読点でつなぐ
- 1文を短くしすぎない。短いフレーズの連続は、区切りが増えてぶつ切りに聞こえやすい
- 数字は算用数字のまま。ただし読み間違えやすい助数詞(「人」など)は、原稿だけかなで書く
- 固有名詞・ブランド名は、ひらがな・カタカナ・区切り方を変えた案を作って聴き比べる
- 英字の略語や記号は、読ませたい読み方で原稿に書く(例:「VAR」→「ビデオ判定」)
- 画面に出す文字と、読ませる原稿は分けて管理する(画面の表記は正しいまま、読みだけ調整する)
設定・ツールでできること
- 話し方の指示:指示文で話し方を変えられるモデルなら、「淡々と」「やさしく」などを試す
- ポーズや読みの指定:SSML(読み上げを細かく指定する書式)や読みの辞書に対応したサービスなら、間や読み方を直接指定できる
- 声を変える:同じ原稿でも声によって得意・不得意がある。ただしシリーズの途中で声を変えると統一感が崩れるので最後の手段にする
- 複数生成して選ぶ:生成ごとのばらつきがある以上、1本目をそのまま使わない
やらないほうがいい後処理
- 速度を後から変える処理で尺を合わせる:今回、音声の速さを後から変える処理(ffmpegのatempoなど)を使うと処理音が出たので使わないことにした。尺は、原稿の文字数と生成時の速さの設定で合わせる
- 動画をつなぐときの手抜き:短い動画を連結するとき、音と映像のずれや音の途切れが出ることがあった。ナレーションは1本の連続した音声として書き出し、映像に重ねる形が安定した
6. 別のプロジェクトでの実例:VOICEVOXで解説動画を量産したときの読み対策
LIFRELLでは、データを使ったサッカー解説のYouTube動画も、AI音声とスライドで量産している。こちらでは無料で使える音声合成ソフトのVOICEVOXを使っており、読み間違いを防ぐための原稿ルールを決めて運用している。ここでも考え方は同じで、画面のスライドは正しい表記のまま、読ませる台本だけを書き換える。
| そのまま書くと | 起きたこと | 台本での書き方 |
|---|---|---|
| 他組 | 「たくみ」と読まれた | 「ほかの組」 |
| 最終節 | 読み方が不安定 | 「さいしゅうせつ」 |
| 4-2-3-1(フォーメーション) | ハイフンまで読もうとして不自然になる | 「4バックにダブルボランチ」のように言い換える |
| 5-0(スコア) | 同上 | 「5対0」 |
| VAR、OG、xG | アルファベットのまま読まれて伝わらない | 「ビデオ判定」「オウンゴール」「エックスジー」 |
| サービス名の英字表記 | 英語読みになったり、一文字ずつ読まれたりする | カタカナで書く(例:FotMob→「フットモブ」) |
もう1つ効いたのが、音声を1本の連続した音声として作ることだ。スライドごとに作った音声と映像を細かくつなぐと、つなぎ目で音が途切れることがあった。そこで、スライドごとの音声と短い無音をつなげて1本の音声ファイルにし、それを画像の連番から作った映像に重ねる方式に変えて、途切れをなくした。
7. 動画の尺と原稿の文字数の目安
ナレーションの長さは、原稿の文字数 ÷ 読む速さ(字/秒)でおおよそ決まる。今回の動画広告で使った6.0〜6.6字/秒を目安にすると、尺ごとの文字数は次のようになる(計算値)。
| 動画の尺 | 6.0字/秒の場合 | 6.6字/秒の場合 |
|---|---|---|
| 15秒 | 90字 | 99字 |
| 20秒 | 120字 | 132字 |
| 30秒 | 180字 | 198字 |
| 40秒 | 240字 | 264字 |
実際には、冒頭や最後にナレーションのない時間を取ることが多いので、そのぶん文字数は減らす。また、同じ原稿でも生成のたびに長さが変わるので、尺ぴったりに書くより、少し余裕を持たせて複数本から選ぶほうが調整しやすい。
8. ナレーション用のAI音声合成ツールを選ぶポイント
ツールによって得意なことが違う。動画のナレーションに使うなら、次の点を確認するとよい。
| 確認すること | 理由 |
|---|---|
| 日本語の自然さ(とくに間とイントネーション) | 同じ原稿を入れて、複数のツールや声で聴き比べるのが一番確実 |
| 話し方を指示できるか | 「淡々と」「明るく」などで雰囲気を変えられると、動画の型ごとに使い分けられる |
| 読みやポーズを細かく指定できるか(SSML・辞書など) | 固有名詞や専門用語が多い場合に、原稿の書き換えだけで済まないことがある |
| 商用利用の条件 | 広告や収益化する動画に使えるか、クレジット表記が必要かを、利用規約で必ず確認する |
| 料金の単位 | 1本ごと・文字数ごと・月額など。複数本生成して選ぶ運用をするなら、1本あたりの単価が小さいほど有利 |
| APIやコマンドで呼べるか | 何本も生成して自動で選ぶ仕組みを作るなら、プログラムから呼べることが前提になる |
9. ナレーション制作のチェックリスト
【原稿】
□ 体言止めが続いていない(「〜ます/〜です」で閉じている)
□ 数字は算用数字。読み間違えやすい助数詞は原稿だけかな
□ 固有名詞・ブランド名の読みは聴き比べで決めた
□ 画面の文字と読み用の原稿を分けて管理している

【生成と選び方】
□ 同じ設定で複数本(目安4本)生成した
□ 字/秒が目安の範囲に入っている
□ 無音の割合が一番小さく、ひと息が長い回を選んだ

【最終確認】
□ 読み間違い(数字・助数詞・固有名詞)を耳で確認した
□ 尺は後処理の速度変更ではなく、原稿と設定で合わせた
□ 画面の文字とナレーションの内容が食い違っていない
動画に声を後から付ける全体の手順はAI動画の音声を差し替える方法(アフレコ)、映像の作り方はAIで動画広告を量産する方法で解説している。
この記事を書いた人
AIで広告・動画をつくる体制を、自社にも
この記事で紹介した制作の進め方(台本の設計、AIで作る部分と本物の素材を使う部分の分け方、確認の手順)を、広告のバナーや動画の量産に使っています。社内で同じ体制を作りたい、まず数本作ってほしい、という相談を受け付けています。
運営:株式会社LIFRELL
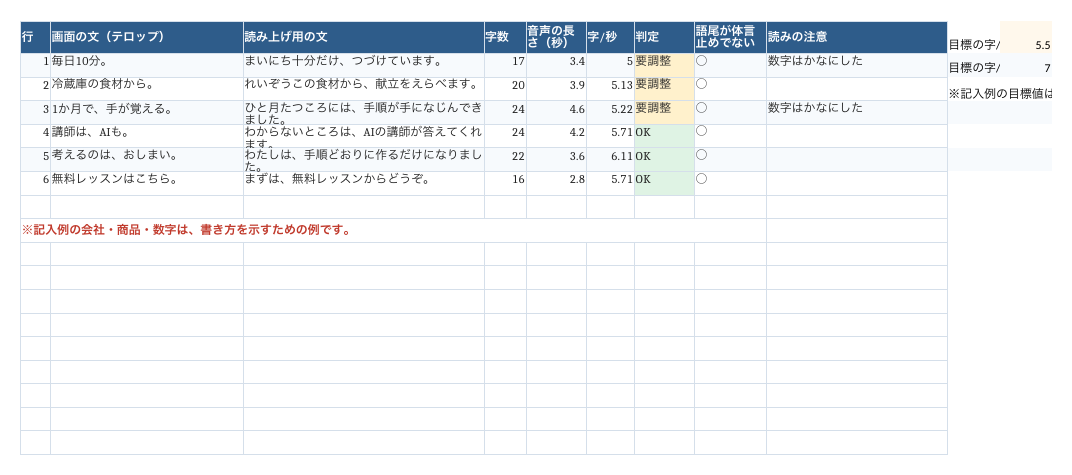
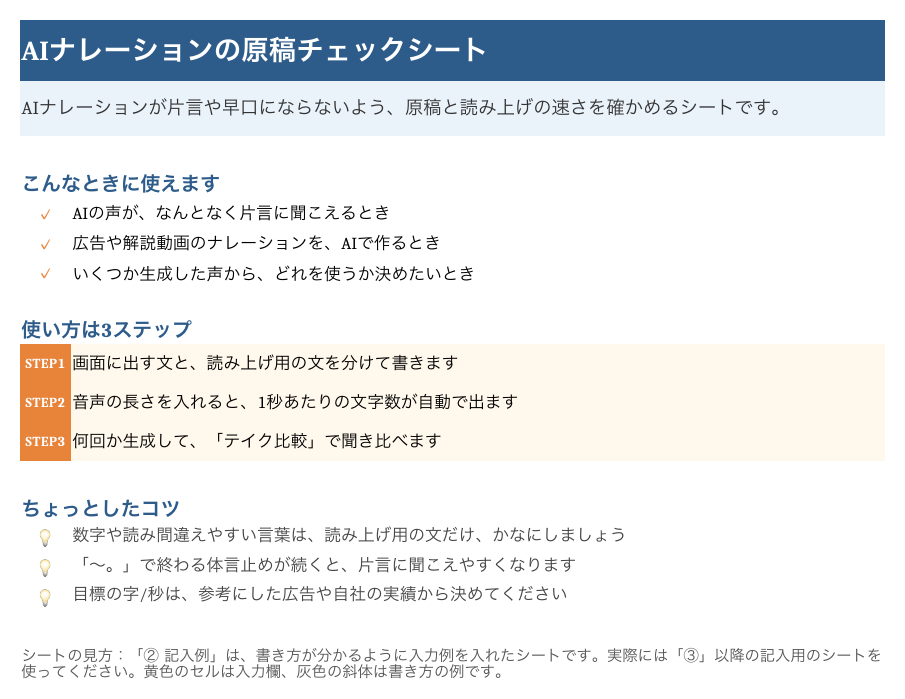
この記事で使った管理シート(無料ダウンロード)
原稿を書き換えて読み上げを直すときに使った表を、テンプレートにした。書き方の例を入れた「記入例」シートと、空欄の記入用シートが入っているので、使い方を見ながら自社用に書き換えて使える。
【無料ダウンロード】AIナレーションの原稿チェックシート(Excel)
画面の文と読み上げ用の文を分けて書き、字数と音声の長さから字/秒を自動計算。テイク比較とチェックリストつき。
スライドとAI音声でYouTube動画を量産する制作ラインは、YouTube動画をAIで量産する方法で解説している。
広告・動画の制作でAIを使った実例は、AIで広告・動画をつくる実例まとめに工程ごとにまとめている。
この記事で紹介したものを含め、実務で使っている依頼文とプロンプトはAI業務の依頼文・プロンプトテンプレート集にまとめている。
よくある質問
Q. AIナレーションが片言に聞こえるのはなぜですか?
A. 今回のケースでは、発音ではなく文の途中に入る無音(間)の多さが原因だった。体言止めを並べた原稿は、合成音声が区切りごとに音の高さを下げて間を入れるため、ぶつ切りに聞こえやすい。
Q. AIナレーションを自然にする一番手軽な方法は?
A. 原稿の書き方を変えることだ。体言止めを並べず「〜ます/〜です」で閉じて読点でつなぐだけで、LIFRELLの実測では200ミリ秒を超える無音が10回から6回に減った。
Q. 同じ原稿なのに、生成するたびに聞こえ方が違うのはなぜですか?
A. 音声合成は生成のたびに間の取り方が少しずつ変わる。同じ原稿・同じ速さでも、無音が6回の回と11回の回が出た。何本か生成して、無音の少ない回を選ぶのが確実だ。
Q. 数字はひらがなで書いたほうが正しく読まれますか?
A. 今回は逆だった。かなで書くと平板に読まれ、算用数字のままのほうが自然だった。ただし「人」のように読み方が分かれる助数詞は、原稿だけ「にん」とかなで書いた。
Q. 無料のVOICEVOXでも同じ方法は使えますか?
A. 使える。LIFRELLでは解説動画の量産にVOICEVOXを使い、読み間違えやすい語(「他組」を「ほかの組」と書くなど)を台本だけ書き換えるルールで運用している。画面の文字は正しい表記のまま、読ませる台本だけを調整するのがポイントだ。
Q. ブランド名のイントネーションがおかしいときは?
A. 表記を変えた案(ひらがな・カタカナ・区切りを入れる・助詞を挟むなど)を作って聴き比べる。画面に出す文字はそのままにして、読ませる原稿だけを変えればよい。
執筆:LIF Tech編集部(株式会社LIFRELL)。動画広告の制作で行った検証(2026年9〜10月)の記録にもとづく。結果は音声合成モデルや声の種類によって変わることがある。