
自分のPCで日本語を使うなら、2026年11月時点ではGemma 4(31B・26B A4B)が第一候補だ。日本語タスクを同じ手順で比べたSwallow LLM Leaderboardで、オープンモデルの中で最も高い平均(0.675)を出している。16GBのメモリならgpt-oss-20bや、その日本語強化版のGPT-OSS Swallow 20B、学習データまで公開された国産モデルを使いたいならLLM-jp-4.1が候補になる。Qwen3.8-27Bは評価の高い新しいモデルだが、日本語の点数を同じ物差しで測った公開結果はまだ少ない。DeepSeek V4.1 FlashとGLM-5.3はオープンモデルではあるものの、数百GB級でPCでは動かしにくく、Ollamaではクラウド版だけが提供されている。本記事では、各社のモデルカードと公開評価をもとに、日本語・サイズ・ライセンスの3点で比べる。
この記事の前提:モデルの仕様とライセンスはHugging Faceの各モデルカード、配布サイズはollama.com、日本語の点数はSwallow LLM Leaderboard(日本語LLM「Swallow」を開発するSwallowチームが運営)と国立情報学研究所LLM-jpの公式ブログで、2026年11月7日に確認した。点数はいずれも公開値の引用で、本記事で独自に測ったものではない。
この記事でわかること
- 用途とPCのメモリ別に、日本語で使うならどのオープンモデルか
- 日本語の強さを同じ物差しで比べた公開スコア
- Gemma 4・Qwen3.8・gpt-oss・LLM-jp-4.1・DeepSeek・GLMの違い(サイズ・ライセンス・Ollama対応)
- 手元で日本語の性能を確かめる手順と、よくあるつまずき
 執筆:佐藤 祐介(株式会社LIFRELL 代表取締役/業界歴15年・マーケティング支援 累計500社以上)
1. 結論:用途別のおすすめ
迷ったらGemma 4から始め、メモリと用途に合わせて入れ替えるのが確実だ。日本語の公開スコア、Ollamaの公式対応、ライセンスの扱いやすさの3つがそろっている。
| こんな人 | おすすめ | 理由(公式情報・公開評価) |
|---|---|---|
| 日本語の質を最優先、24GB以上のGPUか32GB以上のMac | Gemma 4 31B/26B A4B | Swallowの日本語平均がオープンモデルで1位・2位(0.675/0.646)。Apache 2.0 |
| 16GBのGPU・メモリで使いたい | gpt-oss-20b、GPT-OSS Swallow 20B | OpenAIは20bを16GB以内で動くと説明。日本語強化版は日本語平均0.568(元は0.521) |
| 8GB前後のノートPCで試したい | Gemma 4 E4B | 4bit版6.6GB。日本語平均0.484 |
| 国産・学習データの公開を重視 | LLM-jp-4.1(8B/32B-A3B/33B) | 国立情報学研究所が開発。事後学習データまで公開、Apache 2.0 |
| エージェント・コーディングにも使う | Qwen3.8-27B | モデルカードでエージェント・コーディング系の評価が高い。日本語の同条件比較は未掲載 |
| 最高性能のオープンモデルをAPIや社内サーバーで | DeepSeek V4.1 Flash、GLM-5.3-Flash | 数百GB級でPC向きではない。Ollamaはクラウド版のみ |
出典:Swallow LLM Leaderboard(事後学習モデル)、各モデルカード(本文の各章に記載)。2026年11月7日確認。
2. 日本語の強さを同じ物差しで比べる
日本語の強さは、同じ評価手順で多くのモデルを測っているSwallow LLM Leaderboardで比べるのが公平だ。各社のモデルカードの点数は、評価の条件がそろっていないため横に並べられない。
Swallow LLM Leaderboardとは、日本語LLM「Swallow」を開発するSwallowチームが公開している、日本語と英語の評価結果の一覧のこと。内容はCC-BY 4.0で公開されている。「日本語タスクの平均」は、日本固有の知識を問うJamC-QA、英日・日英翻訳、日本語の指示追従(M-IFEval)、日本語版のMMLU-ProXとGPQA、数学(PolyMath)、コード生成(JHumanEval)の8種類の平均で、1に近いほど高い。2026年5月8日の更新で評価の仕組みが新しくなり、Gemma 4やQwen3.5、llm-jp-4が追加された(About)。
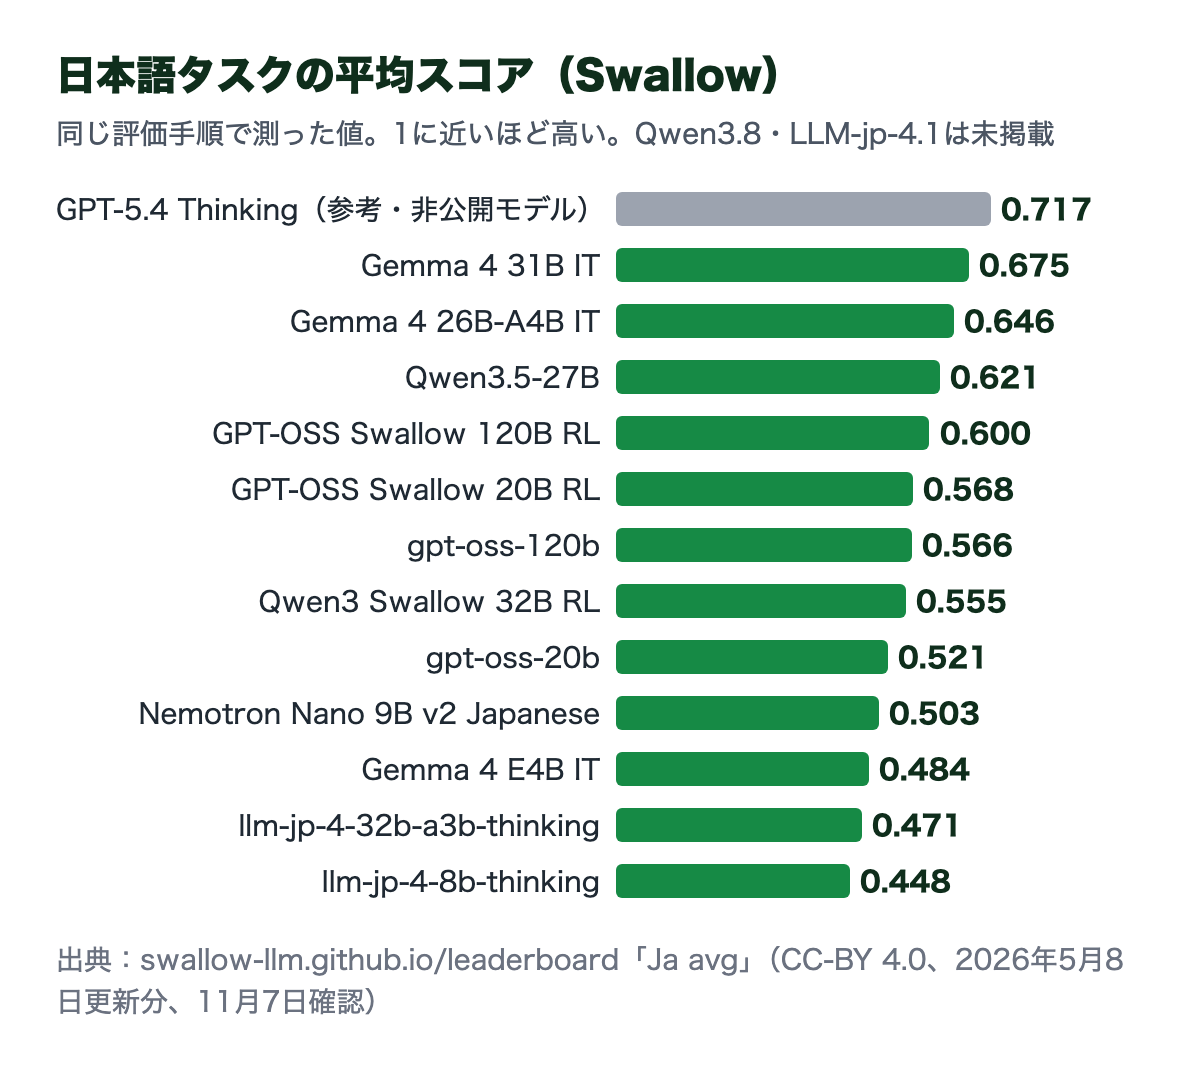
図の要点:オープンモデルではGemma 4 31Bが0.675で最も高く、Gemma 4 26B A4B(0.646)、Qwen3.5-27B(0.621)が続く。非公開モデルのGPT-5.4 Thinkingは0.717で、上位のオープンモデルとの差は0.04ほどだ。
- 日本語強化版は元のモデルより高い:gpt-oss-20bの0.521に対し、日本語で追加学習したGPT-OSS Swallow 20B RLは0.568。120bでも0.566から0.600に上がっている。
- Qwen3.8とLLM-jp-4.1はまだ載っていない:一覧にあるのは一つ前のQwen3.5と、LLM-jp-4(4.1の前の版)までだ。新しい版の点数は、各開発元の公開評価で補う(4章)。
- DeepSeek V4系とGLM-5系も載っていない:両社のモデルカードにも日本語に絞った評価の記載はない。
3. 主要オープンモデルの比較表
PCで動かせるかは「総パラメータ」と配布ファイルの大きさ、業務で使えるかはライセンスで決まる。表の6系統を、この2点と日本語の根拠で並べた。
| モデル(開発元) | サイズ | ライセンス | 扱える長さ | Ollama | 日本語の根拠 |
|---|---|---|---|---|---|
| Gemma 4(Google DeepMind) | E2B・E4B・12B・26B A4B・31B | Apache 2.0 | 小型128K・中型256K | 公式ライブラリ(gemma4) | Swallow 0.675(31B)。35以上の言語に標準対応 |
| Qwen3.8(Alibaba) | 27B(ほかに大型版) | 27BはApache 2.0 | 262,144(最大100万まで拡張可) | 公式ライブラリ(qwen3.8) | Swallow未掲載。LLM-jpの日本語評価では高いスコア |
| gpt-oss(OpenAI) | 20b・120b | Apache 2.0 | 131,072 | 公式ライブラリ(gpt-oss) | Swallow 0.521(20b)/0.566(120b) |
| GPT-OSS Swallow(東京科学大学・産総研) | 20B・120B | Apache 2.0 | 元のgpt-ossに準じる | 公式ライブラリになし | Swallow 0.568(20B RL)/0.600(120B RL) |
| LLM-jp-4.1(国立情報学研究所) | 8B・32B-A3B・33B | Apache 2.0 | 65,536 | 公式ライブラリになし(公式GGUFあり) | LLM-jpの日本語評価で8BがQwen3-8B・gpt-oss-20bを上回る |
| DeepSeek V4.1 Flash(DeepSeek) | 本体5,520億(使う部分80億/160億) | MIT | 100万トークン | クラウド版のみ | 日本語の評価は公式に記載なし |
| GLM-5.3-Flash(Z.ai) | 総3,200億(使う部分180億) | MIT(GLM-5.3はother) | 100万トークン(Ollama表示) | クラウド版のみ | モデルカードの言語は英語・中国語 |
出典:Gemma 4、Qwen3.8-27B、gpt-oss-20b、GPT-OSS-Swallow-20B-RL-v0.1、llm-jp-4.1-33b-thinking、DeepSeek-V4.1-Flash、GLM-5.3-Flashの各モデルカード、gpt-ossの長さはconfig.jsonの値、Ollamaの対応はdeepseek-v4.1-flash・glm-5.3-flashなどのタグ一覧(2026年11月7日確認)。
4. モデル別の特徴
同じ「日本語に強い」でも、強みは系統ごとに違う。ここでは各モデルの公式情報から、日本語で使うときに関わる点だけを抜き出す。
Gemma 4:日本語の公開スコアが最も高い
Gemma 4とは、Google DeepMindが公開しているオープンモデルのこと。E2B・E4B・12B・26B A4B(MoE)・31Bの5サイズがあり、140以上の言語で事前学習し、35以上の言語に標準で対応するとモデルカードにある。多言語の知識を測るMMMLUは31Bで88.4%、26B A4Bで86.3%だ。画像を全サイズで、音声をE2B・E4B・12Bで扱える。ライセンスはApache 2.0(モデルカード)。Ollamaでは gemma4:31b(4bit版20GB)、gemma4:26b(18GB)、gemma4:e4b(6.6GB)のように公式に配布されている。詳しくはGemmaとは?Gemma 4の使い方と5モデル比較にまとめている。
Qwen3.8:新しく高性能だが、日本語の同条件比較はこれから
Qwen3.8-27Bは、Alibabaが2026年8月にHugging Faceで公開したモデルで、画像・動画も読める。ライセンスはApache 2.0、扱える長さは262,144トークンで、最大100万トークンまで広げられる。思考モード(答える前に考える処理)は初期設定で有効だ(モデルカード)。モデルカードの評価はコーディングやエージェント作業が中心で、日本語に絞った点数はない。一方、国立情報学研究所のLLM-jpは、日本語タスクの評価(llm-jp-eval)でQwen3.8-27Bが「特に指示追従で高いスコア」を出し、全体としても高い性能だったと書いている(LLM-jp-4.1 モデルの公開)。Ollamaでは qwen3.8:27b(4bit版18GB)。シリーズ全体はQwen3.8とは?で解説している。
gpt-ossとGPT-OSS Swallow:16GBで使える現実的な選択肢
gpt-ossは、OpenAIがApache 2.0で公開したモデルで、20b(総210億・使う部分36億)と120b(総1,170億・使う部分51億)がある。OpenAIは、20bは16GBのメモリで、120bは80GBのGPU1枚で動くと説明している。決まった会話形式(harmony形式)でしか正しく動かない点には注意がいる(モデルカード)。
GPT-OSS Swallowとは、gpt-ossに日本語で追加学習した日英2か国語のモデルのこと。東京科学大学の岡崎研究室・横田研究室と産業技術総合研究所が開発し、2026年2月20日に公開した。ライセンスはApache 2.0(GPT-OSS Swallow)。日本語の平均は元のモデルより上がっている(2章)。Hugging FaceのMXFP4版は20Bが13.8GB、120Bが65.2GBだ。Ollamaの公式ライブラリには入っていない。
LLM-jp-4.1:国産で、学習データまで公開
LLM-jp-4.1とは、国立情報学研究所の大規模言語モデル研究開発センターが開発する国産モデルのこと。8B・33B(密なモデル)と32B-A3B(MoE)の3種類で、扱える長さは65,536トークン、ライセンスはApache 2.0(モデルカード)。2026年9月28日の公式ブログによると、4.1では事後学習を改善し、ツール呼び出しに対応した。学習に使ったSFT・DPOのデータも公開している。
同じブログの日本語タスクの評価では、8BモデルがQwen3-8Bやgpt-oss-20bを上回る平均スコアで、33Bはgpt-oss-120bに近いスコアだった。一方、Qwen3.8-27Bなどの高性能モデルとの差は残っていると開発元自身が書いている。日本語の会話を採点するMT-Bench(日本語)では、llm-jp-4.1-8b-thinkingが7.58、33bが7.76、gpt-oss-20bが7.33だった(LLM-jp-4.1 モデルの公開)。
公式のGGUF(4bit版で8Bが5.5GB、33Bが20.41GB)があるが、モデルカードは本家のllama.cppではチャットの解析に失敗するため専用のフォークが必要としている。なお、ELYZAはLLM-jp-4の33Bを土台に日本語の推論と知識を強化した「ELYZA-Thinking-1.0-llm-jp-4-33b」を2026年10月にApache 2.0で公開している(モデルカード)。使い方はLLM-jp-4/4.1の使い方で解説している。
DeepSeek V4.1 Flash:オープンだがPCで動かす大きさではない
DeepSeek V4.1 Flashは、本体5,520億パラメータ・使う部分80億/160億のMoEモデルで、画像も読め、100万トークンまで扱える。ライセンスはMIT(モデルカード)。Hugging Faceのファイル情報では総パラメータ約7,632億で、4bitの係数(10億あたり約0.6GB)を掛けても400GBを超える計算になる。Ollamaでは deepseek-v4.1-flash:cloud のクラウド版だけがある。料金や最新状況はDeepSeek V4 Pro/V4.1 Flashの最新状況にまとめている。
GLM-5.3:英語・中国語が中心、ローカルは大型サーバー向け
GLM-5.3-Flashは、Z.aiが公開した総3,200億・使う部分180億のモデルで、GLM-5シリーズで初めて画像を最初から扱える。ライセンスはMIT、上位のGLM-5.3は「other」だ。モデルカードの言語の欄は英語と中国語で、日本語の評価は記載がない。ローカルで動かす方法として、モデルカードはSGLangやvLLMなどサーバー向けの仕組みを挙げている(モデルカード)。Ollamaでは glm-5.3-flash:cloud のクラウド版のみ。前の版の解説はGLM-5.2とは?にある。
5. PCのメモリから選ぶ
使えるモデルは、GPUのVRAM(MacならCPUとGPUで共有するユニファイドメモリ)の容量でほぼ決まる。日本語の点数が高くても、メモリに収まらなければ遅くて実用にならない。
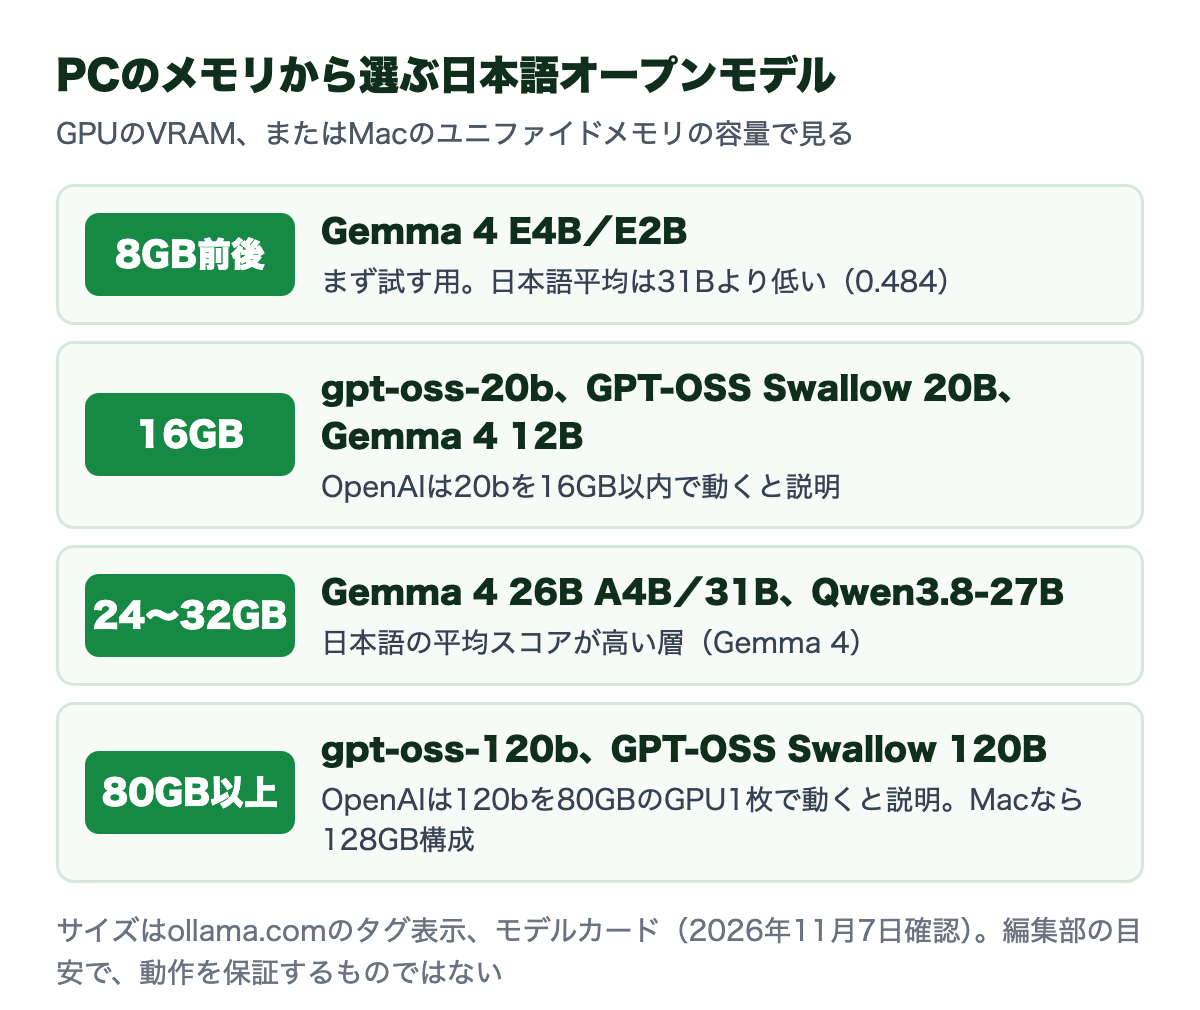
図の要点:8GB前後ならGemma 4 E4B、16GBならgpt-oss-20b系、24〜32GBでGemma 4の上位2サイズやQwen3.8-27Bが入る。120b級は80GB以上が目安になる。
これは4bit版のファイルの大きさから見た目安で、長い資料を読ませると会話の分のメモリが追加で必要になる。計算の方法とVRAM別の早見表はローカルLLMに必要なPCスペックで詳しく扱う。
6. 日本語の性能を手元で確かめる手順
公開スコアは平均値なので、最後は自分の業務の文章で2〜3モデルを比べて決める。Ollamaを使えば、同じ質問を順番に投げるだけで比べられる。
- Ollamaを入れる:公式サイトからインストールする(手順はOllamaの使い方)。
- 候補を2〜3個ダウンロードする:例として
ollama pull gemma4:e4b、ollama pull gpt-oss:20b、ollama pull qwen3.8:27b。メモリに収まるものだけを選ぶ。 - 業務に近い質問を5つ用意する:要約、敬語のメール文、表の読み取り、日本固有の知識(地名・制度)、指示どおりの形式(箇条書き3点など)を混ぜる。
- 同じ質問を各モデルに投げる:
ollama run gemma4:e4bで起動して質問を貼り、ほかのモデルでも繰り返す。 - 評価の観点をそろえて記録する:日本語の自然さ、事実の誤り、指示の守り方、回答までの時間を同じ表に書く。
- メモリの載り方を確認する:別の画面で
ollama psを実行し、「100% GPU」と表示されるかを見る。
画面で操作したい場合は、LM Studioでも同じ比べ方ができる(ローカルLLMの始め方(LM Studio))。
7. よくあるつまずきと対処
多いのは「答えが英語や中国語になる」「思考部分が長すぎる」「国産モデルが正しく動かない」の3つだ。
| 症状 | 主な原因 | 対処 |
|---|---|---|
| 日本語で聞いたのに英語や中国語が混ざる | 多言語モデルが学習量の多い言語に引っ張られる | システムの指示に「日本語で答える」と書く。OllamaならModelfileで固定する |
| 答えが出るまで長い、思考の文章が延々と出る | Qwen3.8などは思考モードが初期設定で有効 | モデルカードの方法で思考を切る、または推論の深さ(reasoning_effort)を下げる |
| LLM-jp-4.1のGGUFで回答が崩れる | 本家のllama.cppがトークナイザーの修正に未対応 | モデルカードが案内するllama.cppのフォークを使う |
| gpt-ossの出力がおかしい | harmony形式以外の会話テンプレートで動かしている | Ollamaの公式タグなど、形式に対応した配布物を使う |
| DeepSeekやGLMをダウンロードできない | Ollamaの公式ライブラリはクラウド版(:cloud)だけ | APIかクラウド版を使う。ローカルならサーバー級の機材が前提 |
8. ライセンスと業務利用の注意
今回の候補の多くはApache 2.0かMITで、商用でも使いやすい。ただし同じシリーズでもサイズによってライセンスが違うことがある。
- Apache 2.0:Gemma 4、Qwen3.8-27B、gpt-oss、GPT-OSS Swallow、LLM-jp-4.1、ELYZA-Thinking-1.0-llm-jp-4-33b。
- MIT:DeepSeek V4.1 Flash、GLM-5.3-Flash。
- other(独自の条件):GLM-5.3、Qwen3.8-Flash-Next。使う前に各リポジトリのライセンス文を確認する。
- 手元で動かせば入力は外に出ない:ローカルで動かす限り、入力した文章はPCの外に送られない。一方、Ollamaの「:cloud」のモデルはOllamaのサーバーで動く。中国企業のモデルを業務で使う際の論点は中国製AIの危険性で整理している。
9. 欠点・制限事項(わからないこと)
- Qwen3.8とLLM-jp-4.1は、Swallowの同じ物差しでの点数がまだない。LLM-jpの評価は開発元自身によるもので、Swallowとは条件が違う。
- DeepSeek V4系とGLM-5系の日本語性能は、公式に記載がない。
- 公開スコアは平均値で、業務での使いやすさとは一致しない。敬語や社内用語、長い文書の要約などは、手元で確かめる必要がある。
- 4bit版での点数は公表されていない。PCで使う4bit版で同じ点数が出るかは、Swallowの一覧に記載がない(gpt-ossは、OpenAIが量子化した状態で評価したと説明している)。
- 評価する側と作る側が同じ場合がある。SwallowチームはGPT-OSS Swallowなど自前のモデルも一覧に載せており、LLM-jpの評価も開発元自身によるものだ。評価方法は公開されているが、第三者による検証とは区別して読む。
- GPT-OSS SwallowとLLM-jp-4.1をOllamaで動かせるかは、Ollama公式に記載がない。
- 速度は測っていない。
10. よくある質問
日本語に一番強いオープンモデルはどれ?
同じ評価手順で比べたSwallow LLM Leaderboardでは、Gemma 4 31Bが日本語タスクの平均0.675でオープンモデルの1位だ。ただしQwen3.8やLLM-jp-4.1など新しいモデルはまだ載っていないため、2026年11月7日時点の掲載モデルでの結果になる。
国産のLLM-jp-4.1と海外モデル、どちらを選ぶべき?
日本語の点数だけならGemma 4などの海外モデルが上だ。LLM-jp-4.1は国立情報学研究所が開発し、学習データまで公開しているため、データの出どころを説明する必要がある用途に向く。開発元も、Qwen3.8-27Bなど高性能モデルとの差は残っていると書いている。
DeepSeekやGLMは自分のPCで動く?
一般的なPCでは難しい。DeepSeek V4.1 Flashは本体5,520億パラメータ、GLM-5.3-Flashは総3,200億パラメータで、4bitでも数百GBのメモリが要る計算になる。Ollamaの公式ライブラリでもクラウド版だけが提供されている。
16GBのメモリなら、日本語でどのモデルを使えばいい?
gpt-oss-20bか、その日本語強化版のGPT-OSS Swallow 20Bが候補だ。OpenAIは20bが16GBのメモリで動くと説明しており、GPT-OSS Swallow 20Bは日本語平均0.568で元のgpt-oss-20b(0.521)より高い。Gemma 4 12B(4bit版8.0GB)も入る。
商用で使えるオープンモデルは?
Gemma 4、Qwen3.8-27B、gpt-oss、GPT-OSS Swallow、LLM-jp-4.1はApache 2.0、DeepSeek V4.1 FlashとGLM-5.3-FlashはMITで公開されている。GLM-5.3など独自のライセンスのモデルもあるため、使うモデルのリポジトリでライセンス文を確認する。
まとめ
日本語で使うオープンモデルは、公開スコアならGemma 4(31B:0.675、26B A4B:0.646)が最も高く、16GBならgpt-oss-20bと日本語強化版のGPT-OSS Swallow 20B、国産と学習データの公開を重視するならLLM-jp-4.1が候補になる。Qwen3.8-27Bは評価の高い新しいモデルだが、日本語の同条件比較はこれからだ。DeepSeek V4.1 FlashとGLM-5.3は数百GB級で、PCよりAPIやサーバー向けである。
今すぐできるアクション:
- 今日:自分のPCのVRAM(Macならメモリ)を確認し、5章の図から候補を2つ選ぶ。
- 今週:Ollamaで候補をダウンロードし、業務に近い5つの質問で日本語の自然さ・誤り・指示の守り方を比べる。
- 来月:採用するモデルのライセンスを確認し、社内で使うルール(入力してよい情報、クラウド版を使うか)を決める。
本記事の内容は、2026年11月7日にHugging Faceの各モデルカード、ollama.com、Swallow LLM Leaderboard、LLM-jp公式ブログで確認したもの。スコアは各サイトの公開値の引用で、本記事で独自に測定したものではない。モデルの公開状況や評価結果は更新されることがある。
関連記事
- Ollamaの使い方|インストール・日本語モデル・エラー対処
- ローカルLLMに必要なPCスペック|VRAM・メモリ別の目安
- Gemmaとは?Gemma 4の使い方と5モデル比較
- Qwen3.8とは?4モデルの違い・料金・ローカルでの動かし方・ライセンス
- LLM-jp-4/4.1の使い方|モデルの違い・GGUF・ローカル導入
- DeepSeek V4 Pro/V4.1 Flashの最新状況
- GLM-5.2とは?価格・性能比較
- 中国製AIの危険性|DeepSeek・Kimi・GLMの業務利用リスク
- ローカルLLMの始め方|LM Studioの使い方
出典
- Swallow LLM Leaderboard:事後学習モデルの結果、About(評価方法・更新履歴)、GPT-OSS Swallow(2026年11月7日確認)
- LLM-jp:LLM-jp-4.1 モデルの公開(2026年9月28日公開、11月7日確認)
- Hugging Face モデルカード:gemma-4-12B-it、Qwen3.8-27B、gpt-oss-20b、GPT-OSS-Swallow-20B-RL-v0.1、llm-jp-4.1-33b-thinking、llm-jp-4.1-33b-thinking-gguf、ELYZA-Thinking-1.0-llm-jp-4-33b、DeepSeek-V4.1-Flash、GLM-5.3-Flash、GLM-5.3(2026年11月7日確認)
- Ollama:gemma4、qwen3.8、gpt-oss、deepseek-v4.1-flash、glm-5.3-flashのタグ一覧(2026年11月7日確認)
この記事を書いた人
業務で使うオープンモデルの「選定・検証・運用」を相談できます
日本語の業務文書で候補モデルを比べる検証の設計、PCやサーバーの構成、ライセンスの確認、社内データを外に出さない運用ルールまで、ご相談をお受けします。まずは無料でご相談ください。
運営:株式会社LIFRELL
